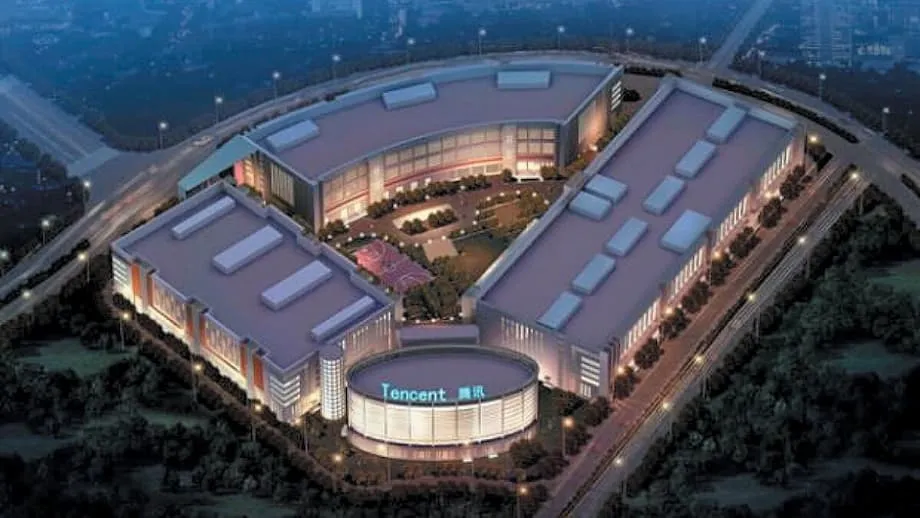
長江沿岸的核心樞紐
中國正將蕪湖市一座面積達760英畝的島嶼,改造成大型資料中心群,作為全國集中人工智慧運算資源計畫的核心。這項計畫常被稱為中國版「星際之門」,串連華為、中國移動、中國電信與中國聯通的伺服器。計畫目標是將分散的設施整合為統一網路,讓運算資源能以大規模方式調度及共享,以因應人工智慧需求飆升、取得最先進處理器管道有限的情況。地方政府表示,與此計畫相關的投資已達2,700億元人民幣,約合370億美元。
目錄
蕪湖這處當地稱為「數據島」的基地,距離上海、杭州與南京不遠。鄰近這些人口密集的城市市場,對人工智慧推論至關重要;推論是訓練完成的模型回覆問題或為使用者生成內容的階段。距離較短可降低延遲,讓語音助理、搜尋、金融風險檢查、零售推薦及城市服務的回應更加即時。中國也正擴建或改造烏蘭察布、貴州與慶陽的設施,以服務其他地區。這些偏遠中心多位於土地較便宜、電力充足的地區,正被指定專注於模型訓練,也就是人工智慧開發中最耗費運算資源的階段。
760英畝數據島將設置哪些設施
業者正在興建大型機房,內設加速器、中央處理器、記憶體、儲存設備及高速交換設備。電信業者已在區域內鋪設並管理光纖路線,因此基地能以高容量連接鄰近城市及其他內陸運算群聚。構想是依據急迫性、成本與可用資源,讓工作負載在網路各處移動,並將某地閒置的資源調度來支援另一地的任務。華為正推廣UB Mesh技術,宣稱可連結分布在多座機房、甚至不同城市的處理器,並透過軟體將它們視為同一個訓練與推論資源池。
為何現在要集中人工智慧運算資源
北京希望提高國內每一枚晶片的效益。近年來,偏遠省分的許多加速器因當地需求有限而未獲充分利用;另一方面,沿海需要運算資源的企業卻難以取得這些產能。全國性網路有望解決這個問題。規劃者預期,串連各運算群聚後,停電時的備援能力將提升,整體設備使用率也會提高,並形成一個市場,讓某地區的多餘運算資源能賣給其他地區的買家。
這項推動也受到地緣政治影響。分析人士估計,美國實驗室掌握全球約四分之三的人工智慧運算能力,中國則約占15%。美國出口管制限制中國取得最先進的輝達GPU,也禁止領先的晶片代工廠為中國客戶製造這些晶片。因此,更妥善地調度國產硬體成為優先要務。集中化是現有的政策工具,國內晶片計畫則試圖追趕領先者。
這套網路將如何運作
計畫明確區分兩種人工智慧工作。訓練是模型從資料中學習的繁重階段,適合運用偏遠基地較便宜的電力與土地;長時間執行的工作可占用數千個加速器數天或數週。推論則是模型回應使用者的階段,會部署在靠近主要城市使用者的地方,因為速度與可靠性比電價最低更重要。
西部負責訓練,沿海地區負責推論
內蒙古與甘肅等偏遠地區,早已設有為雲端或網路服務興建的大型伺服器農場。依照新做法,這些機房將改作模型訓練用途,包括大型語言模型(LLM)。高容量光纖將它們連接至沿海城市,因此已建立檢查點的模型可迅速複製到上海、杭州、廣州及其他都會區附近的推論群聚。
華為UB Mesh與群聚層級調度
要讓這套系統運作,業者需要高速互連技術,以及能協調數千個處理器的軟體。UB Mesh定位為一種互連架構,可降低不同機房或基地之間加速器的通訊負擔。實際而言,這代表採用類似高效能運算的技術,例如遠端直接記憶體存取,以及能讓眾多晶片在訓練超大型神經網路時保持同步的集體通訊函式庫。在互連架構之上,調度器可依據電力供應、適用晶片的閒置情況,或與終端客戶之間的延遲,安排任務執行位置。
補貼與晶片供應緊縮
蕪湖提供補貼,最高可涵蓋人工智慧晶片採購費用的30%。這類地方補助可降低填滿伺服器機櫃的前期成本、加快部署速度,並協助業者提早達到設備密度目標,也能緩解國產加速器與受出口管制的最新外國晶片之間的落差。
華為、寒武紀等國內業者正透過加速器與編譯器軟體努力縮小差距。業者仍得面對規格不一、世代各異的硬體,這可能使訓練作業更加複雜,尤其是模型規模擴大至數兆個參數時。這種壓力也催生了地下市場。轉售商曾試圖取得受限制的輝達系統,並在管制下設法將設備運入中國。一家以蕪湖為基地的中間商據稱曾與Blackwell世代伺服器的訂單有關。輝達否認這類設備在現行規定下能大規模於中國投入使用,並指出供應鏈、許可與支援要求使相關說法不切實際。
哪些人將受益
短期目標是讓主要城市的企業能更快速取得人工智慧推論服務。銀行可降低延遲,進行風險檢查與詐欺偵測;零售業者可部署幾乎即時更新的推薦模型;市府機關可運用電腦視覺管理交通及監測淹水;媒體與設計公司可更快生成影像與影片;新創公司則能按小時租用運算資源,不必預先購買硬體。這套網路藉由串連內陸訓練中心與沿海推論群聚,試圖同時支援實驗開發與日常營運。
電信業者也因此獲得超越連線服務的新角色。它們的資料中心將成為人工智慧時代的重要基礎設施,向雲端客戶銷售運算與儲存服務,同時提供城際頻寬,確保模型同步。對地方政府而言,這項建設有望在施工期間創造就業機會,並為數位服務奠定基礎,吸引新的科技企業在當地落腳。
與美國「星際之門」建設計畫相比
中國正以分階段建構網路的方式串連許多既有機房;美國則支持一系列全新大型園區,名為「星際之門」計畫。投資者與營運商計畫在全美投入最多5,000億美元。路線圖目標是建成近7吉瓦的資料中心容量,相當於約七座大型核反應爐的發電量。德州阿比林的一座指標性園區,設計可容納超過40萬個GPU。計畫夥伴表示,建設高峰期將創造約2萬5,000個現場工作機會。
OpenAI執行長山姆.阿特曼以簡單直白的方式指出利害關係,強調未來人工智慧的進展與支援它的硬體密不可分。在與夥伴公布新基地前,他直言所需規模將十分龐大。
只有建成必要的運算能力,人工智慧才能實現其承諾。
兩種策略的取向不同。美國押注於興建少數超大型園區,在單一圍牆內集中數十萬個加速器;中國則串連新舊運算群聚,再透過調度軟體與新型互連技術,讓它們像更大的整體般運作。美國的做法是在少數地點測試電力、土地與用水供應的極限;中國的計畫則分散風險與成本,同時承擔將多個基地當作單一系統管理的額外負擔。
電力、散熱與網路
現代人工智慧群聚耗電量驚人,並會持續產生必須全天候排除的熱能。蕪湖島上的基地需要新建變電所、輸電線路及備援容量,確保停電時關鍵系統仍能運作。多數訓練機房仰賴液冷,直接從晶片與記憶體帶走熱量,取代舊式伺服器機房常見的氣冷方式。業者將尋找鄰近水源或採用可減少取水量的封閉式循環系統,並要求供應商提高機櫃層級的能源效率。
網路同樣至關重要。將偏遠訓練農場連接至沿海推論群聚,需要具備多太位元容量的光纖路線、能將資料傳送數百公里的光收發器,以及可處理資料中心內部東西向流量、避免瓶頸的交換器。擁有全國骨幹網路的電信業者具有優勢,可配置備援路徑並管理流量工程,確保即使遇上維護作業或天候事件,模型更新與檢查點仍能準時送達。
風險、安全與治理
集中化能改善控制與能見度,但也會讓風險集中。如果太多運算容量仰賴少數網路通道,停電或網路攻擊可能波及多個地區。規劃者表示,透過串連多個基地並設計故障轉移路徑,系統已納入備援。資安團隊必須保護模型權重、客戶資料及調度層本身;一旦調度層掌控大型運算資源池,就會成為攻擊者的重要目標。
實務上也有不少限制。與專為單一世代硬體設計的新園區相比,使用許多較小或較舊的機房可能降低訓練效率。電力合約與電網穩定度必須跟上成長。土地使用決策,包括將農地改作他用,可能受到檢視,尤其是在地方社區感到被迫遷離或糧食生產減少時。補償、環境影響與電網規劃是否透明,將影響公眾是否接受。
接下來的發展
目前工作的重點包括擴建蕪湖第一批機房、將它們連接至內陸訓練農場,以及強化跨基地排程工作的軟體。地方政府正配合補貼時程安排採購週期,鼓勵早期進駐的業者承諾使用運算容量。電信業者則正啟用新的光纖路線並升級骨幹網路,讓模型檢查點能快速從訓練基地傳送至沿海城市附近的推論群聚。
工程師將密切觀察三項指標。第一,UB Mesh及類似互連架構延伸至多座機房時,是否能達到宣稱的效益。第二,國產加速器、編譯器與框架能否以可接受的效率訓練並執行最新模型。第三,電力與散熱供應能否跟上機櫃密度提高的速度,而不造成限電或水資源緊張。這些方面的進展,將決定全國網路擴張的速度,以及它能為全國人工智慧服務的成長帶來多少助益。
重點整理
- 中國正打造集中式人工智慧運算網路,以蕪湖一座760英畝的數據島為核心,相關投資約370億美元。
- 這套網路將蕪湖的設施與烏蘭察布、貴州及慶陽等地的內陸運算群聚連結,以分工處理訓練與推論。
- 華為、中國移動、中國電信與中國聯通是核心營運商;華為正推廣用於群聚間連線的UB Mesh。
- 蕪湖提供最高涵蓋人工智慧晶片採購費用30%的補貼,以加快部署,因應先進外國GPU受到出口管制的情況。
- 中國希望提高既有加速器的使用率,並透過統一調度層,將多餘運算資源跨區銷售。
- 分析人士估計,美國掌握全球約75%的人工智慧運算能力,中國則約占15%。
- 美國「星際之門」計畫目標是建成近7吉瓦的容量,支出最高達5,000億美元,其中包括一座設計可容納40萬個GPU的德州園區。
- OpenAI執行長山姆.阿特曼表示,建成足夠的運算能力,是人工智慧達到預期的必要條件。
- 集中化有望降低沿海主要城市使用者的延遲,並透過串連多個基地提高備援能力。
- 挑戰包括電力與散熱供應、資安、各基地硬體規格不一,以及土地與用水使用受到公眾檢視。