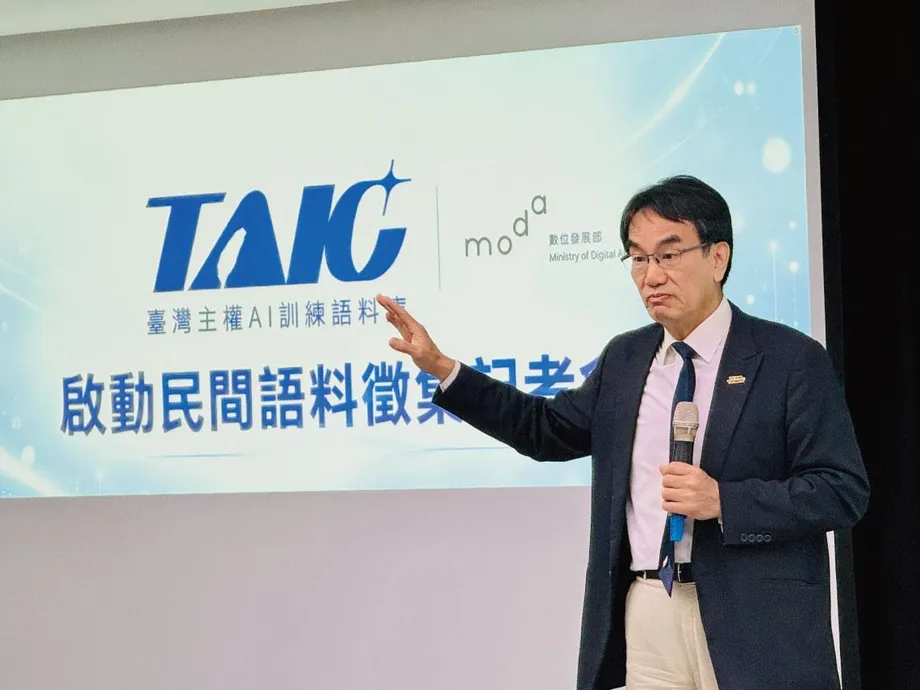
111 筆民間貢獻,凸顯台灣 AI 發展的缺口
台灣政府的 AI 訓練語料庫已累積 7,161 筆資料,但其中只有 111 筆來自民間貢獻者,約占總數 1.6%。對於一項旨在協助人工智慧理解台灣語言、文化與日常生活的計畫而言,這個比例偏低。
目錄
數位發展部於 2025 年 12 月 24 日啟動「台灣主權 AI 訓練語料庫」,共有 200 多個政府機關提供超過 2,000 個資料集,內容達 6 億個 token。Token 是 AI 系統處理的文字小單位,有時是一個字,有時則是單字的一部分。
政府的參與有助於擴大規模。若要納入出版商、作者、教學平台與新聞媒體,面臨的問題就更棘手:開發者需要取得許可,才能複製有價值的文字用於訓練;內容所有者則希望獲得報酬,並掌控作品的使用方式。
在 2026 年 10 月 14 日的立法院聽證會上,數位發展部長林宜敬表示,民間參與採自願方式,政府希望大型 AI 公司,尤其是美國公司,能為訓練內容付費。新聞內容目前不在民間資料蒐集計畫範圍內。
實際利害不只在資料庫規模。以台灣文字訓練的模型,可以學習在地詞彙、說明文化傳統,並以台灣的制度脈絡回答問題。然而,產出這些內容的作者與機構也仰賴作品的商業價值。台灣正試圖擴大作品的使用,同時釐清誰該付費、授權涵蓋哪些範圍,以及著作權規則有哪些地方需要更明確。
政府資料庫收錄哪些內容
數位發展部的12 月啟動公告指出,資料庫涵蓋語言、文化、教育、生物與地理等領域,並使用逾十年的政府開放資料,供使用者搜尋與下載。
文化部提供公共藝術與文化資產相關資料集。教育部則提供涵蓋台語、客語與華語的辭典資料。這些資源讓開發者能取得在地詞義與用法,以及地方、物件和傳統等資訊。
數位發展部的語料庫計畫說明也將原住民族委員會與客家委員會列為參與機關。規劃納入的主題包括歷史、文化資產、觀光與地方文化。數位發展部表示,適合訓練的文字應連貫、完整且流暢。
2026 年 9 月向立法委員提出的數據顯示,資料庫已有超過 5,000 個資料集、逾 24 億個 token。與啟動時公布的 6 億個 token 相比,以 token 計算的文字量已增加超過四倍。7,161 筆資料與 111 筆民間貢獻,則呈現了資料庫組成的另一個現況。
在地語言為何重要
新媒體藝術家、社群知識計畫 Taiwan.md 創辦人吳哲宇認為,主流 AI 訓練資料中的繁體中文比例太低。他估計繁體中文占中文訓練資料不到 1%,並以此說明創立計畫的原因。
吳哲宇關切的不只是把簡體字轉成繁體字。台灣與中國對一些日常事物使用不同詞彙,同一個詞也可能有不同含義。在地知識還涵蓋制度、歷史與飲食,包括國際知名度不如珍珠奶茶或小籠包的料理。
Taiwan.md 使用 AI 工具從網路蒐集資訊,並編輯介紹台灣自然環境、社會與歷史的文章。其 1,123 篇文章取材自可公開取得的學術論文、部落格與政府資訊。吳哲宇希望 ChatGPT、Gemini 與 Claude 等主流模型能接觸更多反映台灣經驗的文字。
政府將相關目標稱為「主權 AI」,意即發展可依台灣自身需求塑造的 AI 資源與能力。政府語料庫提供訓練資料;Taiwan.md 等計畫則希望讓 AI 開發者更容易找到在地知識。
刑事告訴改變了開發者的考量
2025 年 7 月,一名台灣大學博士生因散布含有 14 萬篇未經授權中央社文章的繁體中文語料庫,遭提起刑事著作權告訴。該生從一個提供開放資源的美國網站蒐集資料,並免費分享整套語料。
雙方後來和解。該生道歉,呼籲研究人員確認資料來源是否合法,並移除整套語料庫。
吳哲宇表示,此案讓獨立開發者更加謹慎。Taiwan.md 團隊一旦發現可能有著作權問題,就會捨棄相關資料,拖慢資料庫擴充速度。對小型計畫而言,面臨刑事訴訟的可能性,讓原本就不容易的授權查核工作多了個人風險。
幾個日期呈現了此事的發展脈絡:
- 2023 年初:國家科學及技術委員會啟動 TAIDE 語言模型計畫,投入超過新台幣 2 億元經費。
- 2025 年 7 月:博士生因收錄未經授權新聞文章的語料庫遭提告。
- 2025 年 12 月 24 日:數位發展部公布含 6 億個 token 的主權 AI 語料庫。
- 2026 年 9 月:數位發展部公布資料集已超過 5,000 個,token 數逾 24 億。
- 2026 年 10 月 14 日:林宜敬部長向立法委員表示,民間提供資料採自願方式,付費內容授權協議是政策目標。
著作權如何牽涉 AI 訓練
鹿國法律事務所資深律師陳啟東指出,複製是核心法律問題之一。開發者通常必須先重製文字,才能用於訓練模型。著作權法賦予權利人控制作品重製的權利,但合理使用等例外情況除外。
在特定情況下,合理使用允許未經許可使用受著作權保護的作品。陳啟東表示,台灣現行規定並未明文處理 AI 訓練,因此開發者無法確定法院是否會認可這類使用方式。
訓練模型與生成答案也涉及不同的行為。訓練時,系統處理範例以學習模式;生成時,系統則為使用者產出文字。陳啟東建議立法分別處理這兩個階段,包括輸出內容與受保護作品高度相似的風險。
經濟部智慧財產局表示,可能的法律調整仍在研議中。數位發展部指出,該局負責著作權政策。監察院調查也建議,在行政院交辦智慧財產局後,積極調整法律架構以因應相關發展。
自願授權,而非移轉所有權
林宜敬向立法院交通委員會表示,民間資料蒐集計畫首先從出版社與電子書平台著手。他說明,政府正在尋求以下四類資料:
- 著作權保護期間已屆滿的書籍。
- 出版社提供的書籍介紹。
- 書籍中經挑選的試讀段落。
- 個別作者自願授權的作品。
林宜敬表示,數位發展部尋求取得將作品用於 AI 訓練的許可,著作權仍由作者持有。授權讓另一方得以在雙方約定的條件下,進行特定活動;授權範圍可涵蓋允許的用途、期間等事項。
民進黨立法委員林楚茵質疑,貢獻者將如何獲得報酬、日後撤回許可時該如何處理,以及訓練成果衍生出其他產品時如何保障貢獻者權益。台灣民眾黨立法委員洪毓祥則提議建立服務機制,負責品質檢查、權利清理、付費取得內容,以及管理不同類型的授權。
數位發展部已公布《台灣主權 AI 訓練語料庫授權條款》第一版,並與智慧財產局合作提供範例,協助各機關運用。標準條款旨在減少重複協商與著作權爭議。數位發展部也正規劃提供貢獻誘因。至於報酬標準、撤回授權的安排,以及衍生產品的規範,公開提出的方案尚未定案。
已有付費合作的小型先例
開放文化基金會董事長李柏鋒表示,要求出版社免費提供有價值的資料,不太可能吸引足夠的參與。他以一項小型訓練計畫為例,該計畫透過協商交換,取得媒體與教育平台合作。
合作條件包括一次性授權金、資料使用期限為兩年,以及參與的內容提供者可優先使用訓練後的模型。這項安排讓貢獻者獲得報酬、明確的使用期限,以及實用的回饋。
遠流出版董事長王榮文也主張,政府與商業開發者都應編列內容授權預算。他認為,擔心遭刑事告訴,限制了民間開發者,也讓試圖支持 AI 計畫的公務人員有所顧忌。
林宜敬向立法委員表示,政府最終目標是讓大型 AI 公司付費取得內容。他說,新科技引發的著作權爭議可能持續三至五年,因此數位發展部先從爭議較少的資料著手。他提出的時程描述的是爭議可能持續多久,而非立法或付費制度的期限。
法律例外與集體授權是不同方案
陳啟東建議在台灣《著作權法》中增訂 AI 專章,建立文字與資料探勘例外、要求揭露訓練資料來源,並降低符合條件的活動面臨刑事訴訟的風險。
文字與資料探勘是指使用軟體分析大量資料並找出模式。歐盟、日本與新加坡對這類活動的特定形式設有例外,但規則與條件各有不同。陳啟東認為,這些做法可作為台灣討論的參考。
李柏鋒則建議先採取行政措施,發布指引,說明主管機關認為哪些訓練用途屬於合理使用,哪些可能構成侵權。他以日本文化廳及其 2024 年 AI 著作權檢核表與指引為例,指出這類措施能讓開發者與創作者更清楚掌握實務標準。
陳啟東也建議仿效音樂產業的社團法人中華音樂著作權協會(MÜST),推動集體授權。在這種模式下,組織代表眾多權利人管理授權、收取費用並分配報酬。若應用在 AI 領域,類似服務可減少逐一與數百家出版社或作者協商的工作。
國立臺北科技大學智慧財產權研究所兼任助理教授張仲信則持不同看法。他認為,開發者應依現行著作權規則付費,而不是尋求修改法律。他的主張將透過協商取得有價值的出版與新聞內容,視為解決問題的核心。
TAIDE 顯示資料取得與資源同樣重要
台灣先前推出的「可信任 AI 對話引擎」(TAIDE)顯示,模型可能高度仰賴少數容易取得的資料庫。TAIDE 於 2023 年初由國家科學及技術委員會成立計畫,初期開發經費超過新台幣 2 億元。
TAIDE 從 15 個政府機關取得訓練資料。約 400 萬篇中央社文章占其文字資料的 70%。資料來源在取得時已考量著作權問題,顯示有系統地取得大量新聞典藏,有助於打造在地模型。
計畫主持人、中央研究院台灣資訊安全中心的李育杰說明,擁有本土替代方案的價值:
一開始我們可能還比不上大型引擎,但有自己的對話引擎,至少讓我們有得選。
早期模型以 Meta 的 Llama 2 為基礎,擁有 70 億個參數,也就是模型在學習時調整的數值設定。國網中心有 1,028 張 V100 顯示卡,並於 2023 年 11 月為此計畫採購 9 張 H100 顯示卡,同時維持常規服務。
國立中興大學的農業問答計畫 Demeter GPT 後來從 ChatGPT 改用 TAIDE。副教授范耀中表示,經過額外訓練後,中文準確度有所提升。實驗室先前每次向 OpenAI 查詢需支付新台幣 1 至 2 元;在本地端執行 TAIDE 後,營運成本則轉為自有電腦與電費支出。
台灣的語料庫計畫著眼於這類應用背後的文字供應。政府辭典與文化紀錄提供了基礎。若要更廣泛地取得出版品、專業教學資料與新聞內容,則有賴開發者負擔得起、內容所有者也願意接受的協議。
重點摘要
- 民間貢獻者提供 7,161 筆語料中的 111 筆,約占 1.6%。
- 政府於 2025 年 12 月啟動時公布 6 億個 token;截至 2026 年 9 月,總數已超過 24 億。
- 林宜敬部長表示,民間參與採自願方式,作者仍保有著作權。
- 新聞內容不在目前的民間資料蒐集計畫範圍內,數位發展部則尋求與 AI 公司簽訂付費協議。
- 2025 年 7 月,因 14 萬篇未經授權新聞文章而遭提起刑事告訴,使獨立開發者更加憂慮。
- 提出的方案包括更明確的合理使用指引、資料探勘例外、集體授權,以及依現行法律直接付費。