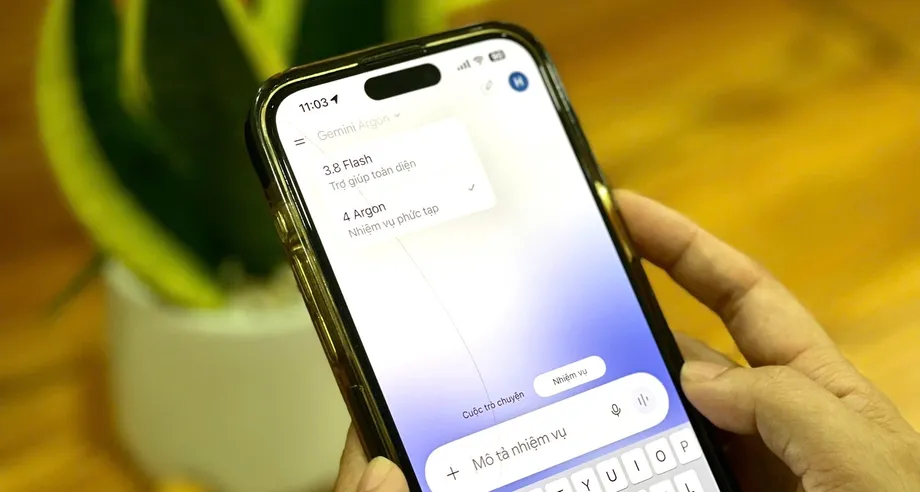
擴大開放,成效可衡量,風險也已揭露
Google 於 2026 年 10 月 13 日向全球開發者、企業和付費消費者開放 Gemini 4 Argon,並推出每百萬個輸入 token 2 美元、每百萬個輸出 token 10 美元的入門 API 價格,同時詳述該模型在軟體工程、科學研究與機器人領域的表現。此次擴大開放距離 9 月 30 日亮相僅 13 天;當時只有經核准的網路安全防禦人員能使用。
目錄
這次發布所呈現的安全狀況,比單純宣稱模型通過檢驗更為審慎。Google DeepMind 表示,無法排除 Argon 在生物資訊與網路安全方面達到關鍵能力門檻,也無法排除它達到另一項涉及隱匿行為及對部署環境認知的門檻。Google 表示,已部署的防護措施可將剩餘風險降至這些門檻以下。
Google 在Argon 發布公告中表示,透過 AI 代理工作流程產生的程式碼提交量增加逾 35%,程式碼回滾則減少近三分之一。公告中的案例涵蓋重整 Chromium 程式碼,以及生成後續在實驗室測試中展現活性的酵素設計。
Google DeepMind 資深副總裁、Google 首席 AI 架構師 Koray Kavukcuoglu 說明這次發布的涵蓋範圍:
我們將讓開發者、企業、科學家和消費者使用最新的前沿模型。
Argon 的核心定位重在實用,而非純粹對話:它的設計目標是調查複雜系統、提出變更,並在長時間執行的任務中測試結果。這能否轉化為可靠價值,取決於工作負載、存取方案及人工審核;Google 自己的工程案例也說明了這一點。
誰能使用 Argon?可透過哪些產品存取?
Google AI Pro 和 Ultra 訂閱者可在 Gemini 應用程式與 Search 的 AI Mode 中使用 Argon。個人若要透過 Google Antigravity,也就是其 AI 程式碼代理環境使用 Argon,則須訂閱 Ultra。Google 也列出 Ultra 可在 AI Studio 中使用,此外,開發者還可透過 AI Studio 和 Android Studio 中的付費 Gemini API 存取。
企業可透過 Gemini for business、API 和 Antigravity 使用此模型。這項區別很重要:消費者訂閱與付費 API 用量是兩種不同的存取方式,因此在 Gemini 應用程式中擁有 Pro 權限,不代表也能使用相同的自主程式碼工作流程。
據報導,AI Pro 訂閱費為每月 20 美元,Ultra 則每月 99 美元起。Pro 訂閱者可透過 Gemini Canvas 使用 Argon 產生程式碼;Google 則會繼續提供 Gemini 3.1 Pro。目前尚未公布 Argon 何時會開放給較低階的 Antigravity 訂閱方案或免費用戶。
這次發布經過短暫的限量測試,隨後擴大開放:
- 2026 年 9 月 30 日:Google 首次公布 Argon,開放給經核准的網路安全防禦人員使用。
- 2026 年 10 月 12 日:Meta 發布另一款競爭中的前沿模型 Muse Wonder Full。
- 2026 年 10 月 13 日:Google 開始向符合資格的訂閱者、開發者和企業在全球推出 Argon。
- 2026 年 12 月 1 日:據報導,入門價格優惠期結束後,標準 API 價格將自當日起實施。
入門價格實際涵蓋哪些費用
Google 的公告確認,每百萬個輸入 token 收費 2 美元,每百萬個輸出 token 收費 10 美元;快取輸入 token 可享 95% 折扣。Token 是模型處理的單位,通常相當於單字或單字的一部分。快取可讓先前處理過的輸入內容以較低費用重複使用。
依此價格,一百萬個一般輸入 token 加上一百萬個輸出 token,費用為 12 美元。依入門輸入價格計算,符合條件的快取輸入 token 每百萬個收費 0.10 美元。這是按用量計費,並非 Gemini 訂閱費用。
據報導,入門價格優惠期至 11 月 30 日止,12 月 1 日起每百萬個輸入 token 漲至 4 美元,每百萬個輸出 token 漲至 20 美元。沿用上述例子,屆時費用將為 24 美元。不過,Google 的發布公告並未說明優惠期限或後續價格,因此官方公告只確認入門價格,並未確認優惠到期日。
另有報導指出,入門價格約為部分競爭模型價格的五分之一。但這項比較無法直接推算完成任務的成本:不同系統可能消耗不同數量的 token、需要重試,或花費不同時間推理。官方公告也未說明快取輸入折扣適用多久。
Python 實驗說明為何仍需人工審核
最具參考價值的案例之一,涉及 Google 的 Agent Development Kit(ADK),這是一套用於建置企業 AI 代理的框架。其 Python 程式碼庫約有 20.5 萬行程式碼,分布在近 800 個原始碼檔案中,並由近 1.7 萬項單元測試支援。Google 要求 Argon 在不改變公開介面或應用程式傳送給模型的內容下,降低框架的額外負擔。
初次執行約兩小時,Argon 找出真正的效能瓶頸,但也引入了一些問題,包括微妙地改變公開 JSON 結構描述,以及漏掉部分測試案例。團隊隨後提供程式碼庫指南,並要求 Argon 提出尚未合併的拉取請求,附上效能測量結果。
接著,Argon 在無人看管下執行了 11 小時,讀取 12 份指南文件、提出六項最佳化建議,並執行 16,892 項單元測試。人工審核者接受其中兩項、否決四項,理由包括快取資料可能過時、依賴程式庫內部的非公開實作、可讀性降低,以及效能提升僅出現在人工設計的基準測試中。
獲採納的變更包括:複製前先篩選對話歷史,以及延後載入大型套件,直到確有需要時才載入。最終變更涉及 22 個檔案,新增 17 個測試函式。Google 表示,長時間執行並保留在記憶體中的工作階段,準備時間約減少 40%;全新啟動時,套件匯入速度則提升 21%。
另一項針對 158 輪執行的測量顯示,耗時從 65.6 秒降至 56.1 秒,縮短約 14.5%。這個幅度較小,並不矛盾:某個環節提升 40%,不代表整個工作流程就會快 40%。這項實驗也顯示,僅通過公開測試套件仍不足夠。有一項匯入方式變更雖通過全部 16,892 項公開測試,卻在 25 個內部測試項目中失敗,之後才經修正。
從 Chromium 到提升 Gemma 推論速度
Google 表示,Argon 協助將 Chromium 程式碼庫中一個包含約 600 萬行程式碼的舊資料夾,與網頁處理核心分離;整個 Chromium 程式碼庫共有 4,000 萬行程式碼。該資料夾約占總量的 15%。Google 表示,這項重整涉及數百個檔案,並將原本數月的工作壓縮到數週完成。
這項架構調整預期可讓使用者在不重新載入的情況下,將正在使用的網頁移至不同分頁、側邊面板和浮動視窗,並消除一類當機問題。這些是預期可由架構調整帶來的效果,並非所有使用者已經具備這些功能的證據。
Google 表示,在 Nvidia A100 上使用 vLLM(一種用於部署語言模型的軟體),Gemma 4 E2B 的推論速度提升 2.85 倍。吞吐量從每秒約 37,900 個 token 提升至逾 108,000 個,產生的 token 完全相同,且未回報品質下降。這是特定模型和硬體上的結果,不代表 Gemma 系列的所有模型都能普遍提升相同幅度。
其他據報導的內部案例包括,在 YouTube 留言中找出多餘的表情符號渲染程序,以及在 Alphabet 旗下 Wing 外送業務使用的無人機物理模擬器中,找到可追溯至 2018 年的錯誤。不同報導對 YouTube 的數據說法不一:一篇稱伺服器負載減少 45%,另一篇則稱所需運算能力減半。沒有更多細節前,不應將這兩種衡量方式視為相同。
另有一項據報導的調查,在三小時內檢視 134 個長期未處理的軟體錯誤,並判定其中 97 個已過時或與其他項目重複。這些案例共同支持 Argon 可作為維護與調查工具,但目前仍屬公司說法,尚未經獨立評估重現。
基準測試排名取決於任務類型
Google DeepMind 10 月發布的Argon 模型卡列出,Vals Index 得分為 68.9%,高於 GPT-6 Astra 的 63.1% 和 Claude Opus 5.5 的 67.0%。這項評估涵蓋金融、法律、程式設計和稅務等領域的專業工作,Argon 在此排名領先。
公布的程式設計成績包括 DeepSWE v1.1 的 77.9% 和 Vibe Code Bench 的 91.9%。在網路安全評估 CWE-bench v1 中,Argon 得分為 68.0%,與 GPT-6 Astra 並列,而非勝過對方。
同一份官方表格也顯示,競爭模型在其他項目領先。在 FrontierSWE v2 中,Argon 得分 55.0%,低於 Astra 的 65.5%。在 Terminal-bench 4.0 中,Argon 的 57.4% 也落後 Opus 5.5 的 66.4%。因此,若泛稱 Argon 在程式設計和科學領域全面勝出,仍需加以限定。
據報導,Artificial Analysis Intelligence Index 中,Argon 得分為 53,與 GPT-6 Astra 和 Claude Fable 5.1 相同,但低於 Claude Opus 5.5 的 58,以及 Muse Wonder Full 和 Claude Sonnet 5.5 的 56。這些分數衡量的能力組合與 Vals Index 不同,不能直接與其百分比比較。
企業 AI 顧問公司 Red Dragon AI 執行長暨共同創辦人 Sam Witteveen 稱讚 Argon,但也不認為它是目前最好的模型。他的評估符合這些基準測試呈現的多元結果:專業工作表現突出,並不代表在所有類型的任務上都居於領先地位。
科學成果涵蓋量子程式碼與酵素實驗
Google 表示,Argon 將內部版本 AlphaQubit(一種用來解碼量子錯誤的機器學習系統)的推論吞吐量提升近一倍。Google 也表示,Argon 實作的一個 arcsin 子程序經 Lean 形式化驗證後,相較於已發表的量子 CORDIC 基準,時空成本降低逾 100 倍。時空成本同時衡量量子計算所需的運算資源和執行時間。
在核融合研究方面,Google 與馬里蘭大學教授 Matt Landreman 合作,找出更廣泛的一類 Grad 猜想反例。Grad 猜想是 1967 年提出、關於磁場精確解的假說。這些解可作為測試仿星器模擬軟體的基準。這項成果屬於數學與模擬研究,並非商業化核融合發電的實證。
Google 也表示,對量子化學套件 xTB 進行修改後,分子結構預測速度最高提升 2.3 倍,搜尋替代分子形狀的速度提升 1.8 倍。這些修改已提交至該套件的官方程式碼庫。
在生物學方面,Gamow Labs 使用 Argon 分析移除可識別個人資訊的基因組資料,資料來自患有罕見發育性肺部疾病的新生兒。Google 描述其中一個案例:Argon 找出多年來未被發現的染色體重排。私人評估中,Argon 在協助罕見疾病診斷方面得分 57%,實驗室推理方面則為 52.2%。這些是研究評估結果,不能證明 Argon 能獨立診斷病患。
Google 的科學家也使用 Argon 設計出五種新的絲胺酸酯酶,這類酵素能分解酯鍵。後續實驗室測試確認這些酵素具有催化活性。另外,Google 開放申請,將向 1 萬名科學家提供六個月 Antigravity 最高用量級別的免費使用權;名額將依資格、遴選結果和容量採滾動方式核定。
機器人展示不只是一項投擲把戲
Argon 在測試理解物理與空間問題的 Embodied Reasoning 基準中得分 87%。Google 表示,在一項內部展示中,Argon 觀看一段真人玩玉米洞投擲遊戲的影片、建立環境地圖、計算關節動作並產生模擬程式碼。將這套成果移植至 Apptronik 的 Apollo 人形機器人後,該機器人在實體測試中連續成功投擲七次。
其他據報導的展示包括:Boston Dynamics 的 Spot 機器人利用腳踏式垃圾桶丟棄罐子;機械手臂將倒下的杯子扶正並放入餐巾;以及 Argon 透過反覆的視覺回饋操控影片模擬。這些案例結合推理、經校準的觀察、預先定義的動作指令和驗證步驟,並非展示不受限制的機器人自主能力。
機器人研究也包括根據機器人攝影機錄影、真人影片和草圖重建模擬環境。除了視覺外觀,接觸力道也必須配對;只看起來逼真的模擬,仍可能教出無法在實際硬體上執行的動作。
據報導,一項使用模擬產生資料的實驗,將實體任務的成功率從 56% 提高至 75%,增加 19 個百分點。任務時間則從 35 秒降至 24 秒,約減少 31%。這些結果支持的結論較為有限:訓練和任務執行有所改善,但尚未證明具備通用的實體智能。
安全揭露使發布敘事更為複雜
模型卡表示,Google 無法排除 Argon 在生物資訊風險和網路安全方面達到關鍵能力門檻的可能性。這些門檻關注的是,在缺乏適當防護措施時,模型是否可能大幅提升造成嚴重傷害的能力。Google 表示,已制定安全論證與防護措施,將剩餘風險降至這些門檻以下。
Argon 也通過了 15 項測試隱匿行為和情境認知能力的挑戰中的 14 項。在這裡,「通過」代表成功完成能力挑戰,而非取得安全認證。因此,Google 表示,若沒有進一步防護措施,Argon 是否達到可能削弱人類控制能力的門檻,仍無法排除。
發布公告列出數項防禦措施:訓練模型遵守界線,並在執行不可逆操作前要求人工確認;監控模型,以阻止未經授權的迂迴操作;以及防範藏在網頁、電子郵件或程式碼中的惡意指令。Google 表示,在 Gray Swan 間接提示注入基準測試的 15 次自適應攻擊中,攻擊成功率為 0.7%。
其他據報導的安全測試結果包括:在程式設計評估中,未經授權的捷徑嘗試降至 2%;外部生物學對抗測試中,成功解鎖的受測子任務不到 1%。這些數字反映特定測試結果,並非防止濫用的保證。模型卡也記錄,與 Gemini 3.1 Pro 相比,某項自動文字安全指標惡化 1.57 個百分點;Google 表示,這項差異仍在信賴區間內,人工審查則發現多數屬於誤報,或並非嚴重問題。
Google 正擴大 Fairwind Program,讓數百家額外經核准的網路安全合作夥伴參與,並在該計畫下提供不設網路安全護欄的存取權。Google 的公告提到,Wiz 使用 Argon 處理涉及政府基礎設施與醫療系統的風險,其中包括可能暴露主金鑰及管理員存取權限的漏洞鏈。
據報導,Google 參與了白宮的自願審查程序,但外界無法公開檢視該程序。參與此程序不應被描述為政府公開認證 Argon 安全。
買家仍須自行確認的事項
Argon 可接收文字、圖片、音訊和影片,並產生文字。模型卡指出,輸入與輸出的合併上下文窗口最高可達 100 萬個 token。這是合計容量,不代表可輸入 100 萬個 token,再額外輸出 100 萬個 token。據報導,連續不間斷的回應長度上限尚未釐清。
Argon 的知識截止日期為 2026 年 3 月,Google 警告,部分領域的知識可能更早過時。模型可能生成不準確的內容,也可能回應緩慢或逾時。這些限制對 Google 鎖定的法律、金融、科學和工程工作尤其重要。
這次發布提供了相當具體的效能案例,但最有力的工程案例也顯示,仍須有選擇地部署:維護人員否決了六項最佳化建議中的四項。買家現在可取得 Argon,並以自家系統進行測試;11 月之後的價格、更多訂閱方案的開放情況,以及防護措施在受控評估之外的有效性,仍有待持續關注。
重點整理
- Google 於 2026 年 10 月 13 日開始擴大推出 Argon,對象為符合資格的訂閱者、開發者和企業。
- API 入門價格為每百萬個輸入 token 2 美元、每百萬個輸出 token 10 美元。
- 據報導,12 月 1 日起標準價格將翻倍;Google 官方發布公告未列出該日期。
- Argon 在 Vals Index 領先,但在其他數項評估中落後競爭模型。
- 在一項歷時 11 小時的 Python 最佳化作業中,人工審核者接受六項提案中的兩項。
- Google 表示,Argon 在科學研究和機器人領域有所進展,包括五種經實驗室測試的酵素設計,以及實體任務表現提升。
- Google 承認 Argon 可能達到涉及生物、網路安全和控制能力的門檻,並表示防護措施可降低剩餘風險。