三星將記憶體容量與處理速度並列
三星電子正將 AI 基礎設施策略拓展至高頻寬記憶體之外,將 HBM5 與客製化記憶體,搭配和 AMD 合作的共享伺服器記憶體,以及將部分資料處理移至 SSD 的儲存技術。三星在 2026 年 OCP 全球高峰會上介紹這項策略;活動預定於 10 月 12 日至 15 日在加州聖荷西麥克恩利會議中心舉行。
目錄
最具體的效能數據來自記憶體階層中其他位置的技術。三星表示,透過彈性配置 CXL 記憶體,AI 模型產生第一個 token 前的等待時間最多可縮短 38%;採用 LPDDR5X 記憶體內處理,推論效能最高可達三倍;SSD 順序讀取速度則達每秒 28.4 GB。這些是特定評估或展示中的結果,並非適用於所有 AI 部署的保證。
三星的高峰會官方網頁將策略分為速度、記憶體擴充與資料持久性。展示產品包括 HBM4E、LPDDR5X-PIM、CMM-D MD310 記憶體模組、SOCAMM2 伺服器記憶體,以及 PM1763 和 BM1773 SSD。
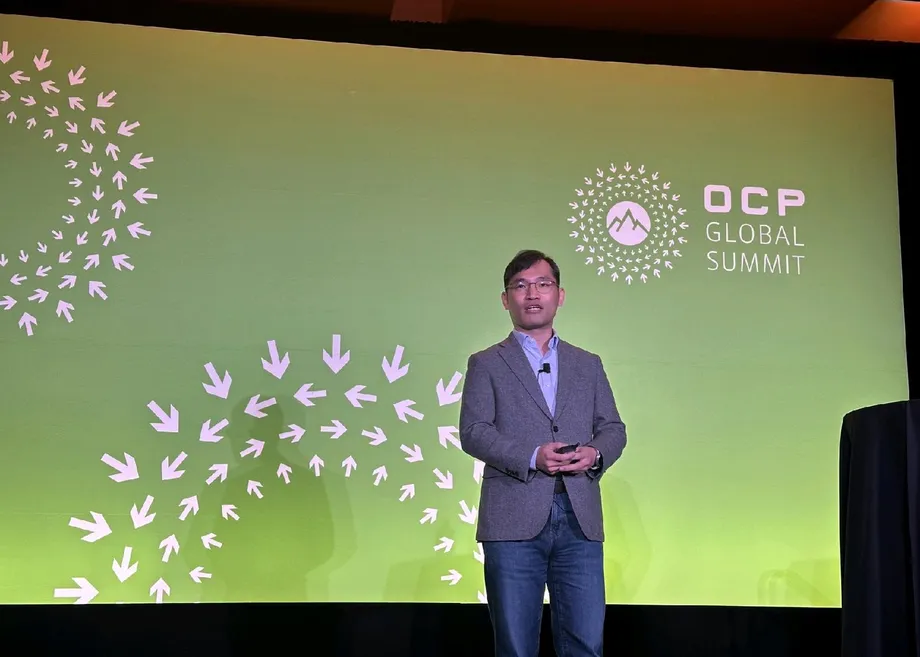
三星指出,企業副總裁兼記憶體事業部應用工程團隊主管沈浩俊(Hojun Shim)預定於 10 月 12 日在一場主管專題場次中,介紹這三大優先方向。相關報導將這場演講描述為更廣泛計畫的起點,目標是整合處理器、記憶體與儲存裝置進行最佳化,而非分別改善各個元件。
這項區別在推論階段尤其重要,也就是已訓練的模型產生回答時。高速加速器仍可能因等待資料而耗時,對話愈長也可能面臨記憶體不足,或在從儲存裝置擷取資訊時遇到延遲。三星針對這些限制分別提出不同技術。
HBM5 領銜更全面的速度策略
展覽相關報導將 HBM5,也就是第八代高頻寬記憶體、客製化 HBM 與 zHBM 列為三星提升速度的方案。高頻寬記憶體透過大量平行連線,向加速器提供大量資料。客製化版本則旨在配合個別客戶的系統需求。
官方產品清單列出的是 HBM4E,而非 HBM5。其他報導則稱展覽中展示了 HBM4E 與 HBM5 概念模型。這項差異很重要:展品或概念展示並不能證明產品已開始出貨;三星高峰會網頁也未提供 HBM5 的商用上市日期或詳細效能規格。
記憶體處理速度方面,最有力的數據來自 LPDDR5X-PIM。記憶體內處理是將部分運算放在記憶體裝置內執行,以減少記憶體與獨立處理器之間反覆傳輸資料的需求。三星表示,其設計將處理單元整合至每個記憶體 bank。
三星以 Llama 3.1 8B 搭配三星 Edge AI 加速器進行評估,表示相較傳統 LPDDR5X,有效頻寬最高可達八倍、每秒生成的 token 數最高可達三倍,執行時間最多可縮短至原本的 1/2.2。這些數據適用於該款加速器與模型,並非 HBM5 或 AMD 記憶體展示的結果。
同樣列入展示的 SOCAMM2,是一款採用 LPDDR 的伺服器記憶體模組。整體展品顯示,三星的速度策略涵蓋加速器記憶體與低功耗記憶體技術;不過,高峰會網頁並未提供所有產品可直接比較的基準測試結果。
與 AMD 合作,提升記憶體容量彈性
三星與 AMD 展示了運用三星 CMM-D 技術擴充 CXL 記憶體。CXL 是 Compute Express Link 的縮寫,可連接處理器與其他裝置,並提供額外記憶體,讓系統擴充容量,不受限於直接安裝的記憶體。
CMM-D 是採用 CXL 的 DRAM 記憶體模組。在池化配置中,多個系統可從連接的記憶體資源中調用容量,而非將容量永久分配給個別伺服器。三星表示,與 AMD 的合作驗證了 CXL 可用於擴充記憶體容量與頻寬,並減少 CPU 核心等待資料的時間。
當 AI 代理程式執行多個模型或任務時,這項問題會更加明顯。三星官方說明指出,代理程式工作負載可能大幅增加 CPU 使用量,但記憶體容量未必能跟上處理器核心數量的成長。
另一場 CMM-D 池化展示,則是在 GPU 伺服器上的多個大型語言模型執行個體之間進行彈性配置。三星表示,相較靜態配置,首次 token 等待時間(TTFT)最多可降低 38%,有效吞吐量最高可提升至 3.3 倍。TTFT 衡量回應開始前的等待時間;有效吞吐量則衡量依評估標準完成的有效工作量。
不應將這些結果視為 AMD 展示本身的數據。官方網頁將 AMD 驗證與彈性配置基準測試分別說明,也未提供足夠細節,無法判定模型、伺服器配置或服務目標不同時,效能增益會如何變化。
KV 快取連結記憶體擴充與儲存
串連三星記憶體與儲存策略的核心技術之一,是鍵值快取,通常稱為 KV 快取。它會保留語言模型處理文字時產生的中間資訊,讓模型可以重複使用既有運算結果,而不必每生成一個新 token 都重新計算。
長對話、更大的上下文以及多位使用者同時使用,都可能讓這些快取占用大量記憶體。三星提出一種階層式架構:透過 CXL 記憶體擴大可用容量,並將不必留在最快記憶體層的快取資料存放於 SSD。
高峰會官方網頁介紹了三星半導體美國園區的一項正式部署,服務內部 AI 程式設計代理程式及其他應用。三星表示,透過 AI Memory Node 解決方案新增 L3.5 可組合式記憶體層後,KV 快取使用率提升至原本的五至七倍。
L3.5 是這個額外記憶體層的名稱,並不代表所有伺服器都採用相同的快取架構。這項部署由三星記憶體解決方案實驗室、DSA AI 平台整合團隊與 SGLang 共同參與。使用率提升的結果,與彈性配置基準測試及 LPDDR5X-PIM 效能數據各自不同。
高峰會議程也安排於 10 月 13 日舉行一場專題,探討結合 CXL 池化與 SSD 儲存進行 KV 快取卸載,由系統架構師蘇進仁(Jinin So)及首席工程師崔永河(Youngha Choi)主講。這項整合不只是擴充容量而已:軟體還必須能在記憶體與儲存裝置之間配置及擷取資料,同時避免造成過多延遲。
SSD 同時承擔容量、散熱與資料配置任務
三星的資料持久性策略以企業級 SSD 和高容量 NAND 快閃記憶體為核心。資料持久性是指在運算暫時工作狀態結束後仍保留資料,讓 AI 系統在需要時可擷取資料集、模型檔案與已儲存的快取資訊。
PM1763 定位為 PCIe Gen6 企業級 SSD,順序讀取速度最高達每秒 28.4 GB,電源效率最高可達前一代的 1.8 倍。三星的液冷展示將 E1.S 版本直接接觸冷板,以帶走熱量。官方網頁未提供這項效能比較的完整測試條件。
BM1773 列為搭載 256TB QLC 儲存空間的 E3.S SSD。QLC 即四階單元,每個快閃記憶體單元可儲存四個位元,支援高容量設計。相關報導也提及,三星持續開發高容量 QLC 快閃記憶體與彈性資料配置技術。
三星展示了整合至 LMCache 的 KV 快取最佳化技術。彈性資料配置(FDP)可協助安排資料寫入位置,以降低寫入放大,也就是 SSD 實際執行的內部寫入量超過主機提交資料量的情況。
展示也運用更大的 NVMe 最大資料傳輸大小,以減少主機 CPU 的工作量。三星表示,這些技術適用於單一節點內的快取儲存,也適用於多台伺服器共享的快取資源。活動網頁未提供這些特定最佳化的量化效能提升數據。
讓運算更靠近儲存資料的位置
三星的向量資料庫展示,提供另一種減少資料搬移的方法。向量資料庫會儲存資訊的數值表示方式,並加以比對以找出相似項目;AI 應用擷取與使用者請求相關的文件時,常會執行這類步驟。
NCVS 概念驗證將向量距離計算移至 SSD 執行。裝置不再將 4KB 向量傳送至主機進行比對,而是回傳四位元組的距離結果。三星表示,相較傳統由主機處理的路徑,主機流量最多可減少至原本的 1/22;增加 SSD 數量則可提高搜尋吞吐量。
四位元組與 4KB 分別指單筆結果與向量的大小,並不代表整個應用的流量也會按相同比例降低。最多降低至原本 1/22,是整體測量比較結果。三星將 NCVS 定位為概念驗證,並非一般市場上可取得的產品。
AiSIO 展示則透過通用軟體介面,支援由 GPU 發起、點對點及由 CPU 發起的傳統儲存輸入輸出作業。三星表示,透過 OpenDS,每秒可處理 1 億次輸入輸出作業,語言模型的冷啟動載入速度最高可提升至十倍。
這些指標衡量的是不同作業。順序讀取速度反映持續資料傳輸能力;每秒輸入輸出作業數計算儲存請求;冷啟動載入則衡量模型準備就緒的速度。這些指標都不能直接取代完整 AI 服務可處理多少使用者請求的基準測試。
客戶測試與晶圓代工展示擴大布局
Samsung MAX Lab 的目標是在開發流程較早階段邀請客戶參與。客戶可在商用化之前,於貼近實際的 AI 工作負載下測試 PIM、CMM-D 與新一代 SSD 等技術,並將系統需求回饋至產品設計。
這項做法回應了高峰會各項展示反覆呈現的實際問題:元件速度再快,只有軟體與周邊硬體能善加運用,才能創造價值。三星全球開放生態系統團隊參與開源開發與產業標準制定,活動議程也包括軟體框架、儲存命令處理與記憶體管理等場次。
三星也展示了支援即時遷移及透過標準 NVMe 管理虛擬 SSD 的可組合式儲存。官方說明將此技術定位為讓多個租戶共享儲存空間的方案,並可執行服務品質管理,也就是控管各工作負載所獲得的服務。
展覽內容不只涵蓋記憶體。相關報導指出,展品包括以三星晶圓代工 4 奈米製程生產的 Groq 語言處理器晶圓、若干報導稱為 Nvidia 系統的 Groq 3 LPX 系統,以及採用三星 2 奈米環繞閘極製程的晶圓。這些展品將製造能力與記憶體、儲存技術一併呈現,但並不能證明已有新的生產合約或出貨數量。
合作關係歷經數月逐步發展
三星與 AMD 的展示並非孤立事件,而是延續先前合作。相關報導指出,雙方於 3 月簽署合作備忘錄,涵蓋新一代 AI 記憶體與運算技術;接著在 AMD 執行長蘇姿丰 10 月 7 日訪問南韓期間進行討論。
相關發展與高峰會預定場次如下:
- 2026 年 3 月:三星與 AMD 簽署合作備忘錄;三星也在 Nvidia GTC 展示技術。
- 2026 年 6 月與 8 月:三星分別在 COMPUTEX 與 Future of Memory and Storage conference 展示技術。
- 2026 年 10 月 7 日:蘇姿丰訪問南韓,並與三星 DS 部門副董事長全永鉉會面,討論記憶體與運算合作;相關報導也提及晶圓代工方面的討論。
- 2026 年 10 月 12 日:高峰會開幕,沈浩俊預定當天發表主管專題演講。
- 2026 年 10 月 13 日至 15 日:三星議程包括 KV 快取分層、儲存最佳化與共享 CXL 記憶體架構等場次。
三星以鑽石級贊助商身分參與。相關報導對策略公布日期的說法不一,有的以當地時間 10 月 12 日為準,有的則以三星 10 月 13 日的聲明為準。這兩個日期可能分別指同一活動的不同階段。有一篇報導將高峰會地點寫為舊金山,但三星官方議程列出的地點是聖荷西會議中心。
市場規模不代表商用已就緒
據報導援引的產業研究數據,三星在 2026 年第二季全球 DRAM 營收市占率達 39%,排名第一;NAND 快閃記憶體市占率則為 29.3%。DRAM 數據來源為 Counterpoint Research,NAND 數據來源為 TrendForce。這些是市場占有率數據,並非三星在新興 CXL 或記憶體內處理市場的市占率。
報導引述 Omdia 預測,三星當年 DRAM 與 NAND 晶圓產量將居業界之冠。另有估算指出,三星每年 DRAM 產能約為 817.5 萬片 300 毫米晶圓等值。產能不等於實際產量,這些數據也無法說明三星將多少產能分配給 OCP 展示的技術。
另有一篇報導列出 10 月 8 日公布的初步第三季數據,數字異常龐大:營收 195 兆韓元、營業利益 107.4 兆韓元,利潤年增 782.5%。本文未提供官方財務公告佐證這些數字,不應將其視為高峰會相關技術已帶來收益的確切證據。
競爭也已超越 HBM。相關報導指出,SK hynix 的 Memory-Centric AI Rack System(MARS)採用在機櫃內共享的 CXL 記憶體池。這與三星讓多個系統共享閒置記憶體的方向相似,但目前沒有可比較的基準測試能判定哪一種方案效能較佳。
三星表示,目標是提升 HBM、伺服器 DDR5 與企業級 SSD 的競爭力。尚未確定的商業細節包括 HBM5 何時上市、定價、客戶是否廣泛採用,以及效能數據能否獲得獨立驗證。高峰會議程提供的是展示與討論日期,並未替所有技術訂出確切上市期限。
重點整理
- 三星在 OCP 2026 展示的策略結合高速記憶體、CXL 容量擴充與具資料持久性的 SSD 儲存。
- 與 AMD 合作運用 CMM-D 記憶體技術,因應 AI 日益增加的記憶體需求。
- 另一項彈性池化展示顯示,首次 token 等待時間最多可降低 38%,有效吞吐量最高可提升至 3.3 倍。
- LPDDR5X-PIM 評估結果顯示,在三星 Edge AI 加速器上,推論效能最高可達三倍。
- PM1763 儲存、KV 快取最佳化與 SSD 內運算,分別針對不同的資料搬移限制提出方案。
- 高峰會公布的資訊並未確定 HBM5 出貨日期或廣泛商用時間。