全國生物資料捐贈計畫擴大招募對象
南韓正擴大一項全國生物資料庫計畫的招募,目標是在 2032 年前整合 100 萬人的健康與基因資訊,並規劃至 2028 年投入 6,600 億韓元。政府希望這項資源能支援醫療人工智慧、新藥開發,以及為個別患者量身打造的治療。
目錄
10 月 15 日發布的公告擴大了參與資格,不再限於接受國家或一般健康檢查的人。未納入這些篩檢計畫的民眾,如在招募機構完成指定檢查,現在也能加入。這項變更也涵蓋過去因年齡或就業狀況而無法接受國家篩檢的人。
公告指出,截至 10 月 14 日約有 23.8 萬人完成登錄,並預定於 11 月首次釋出涵蓋約 12 萬人的研究資料。另一份標註日期為 2025 年 12 月 1 日的資料記載,已有約 11 萬人提供臨床與基因體資料,並預期在 2026 年第四季首次釋出資料。10 月公告未註明年份,因此這些登錄數字與資料釋出時程之間的關係尚不明確。
計畫的共同目標則相對明確:在取得參與者同意後收集生物檢體,將檢體與健康紀錄串聯,並讓獲准的研究人員在受控的運算環境中研究這些整合資訊。
志願者參與方式有哪些改變?
保健福祉部、科學技術資訊通信部、產業通商資源部,以及疾病管理廳共同公布了擴大後的參與資格。過去招募對象主要是已在接受健康檢查的人,因而能在既有就診過程中取得檢查結果。
未納入這些計畫的民眾,現在也可透過招募機構安排的檢查參與。參與仍屬自願,並須經過同意、檢體採集及身體測量。10 月公告指出,全國共有 48 個招募機構,每天平均新增 600 至 700 名參與者。
10 月 15 日,保健福祉部長鄭恩敬與國家人工智慧戰略委員會副主席河正宇,在首爾延世大學新村世福蘭斯醫院出席捐贈活動,現場約有 40 人參加。韓國保健產業振興院院長高尚白及醫院相關人士也出席活動。
活動一方面公開呼籲民眾捐贈,另一方面也討論計畫執行、研究資料取用,以及如何將資料用於醫療人工智慧。對志願者而言,實際改變在於不必先符合例行健康篩檢資格,也能登記參與。
生物資料庫收錄哪些資料?
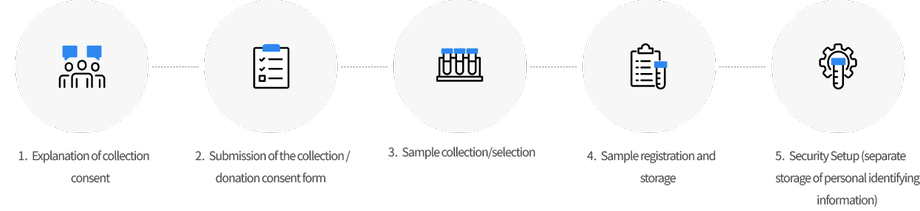
計畫主持人白龍民表示,這項資源將串聯多種資料。計畫的官方組織概覽指出,在取得參與者同意後,計畫會收集血液、尿液及組織等檢體,並整合臨床紀錄、基因體資料、公部門持有的資訊,以及個人產生的健康資訊。
生物資料庫保存人體檢體,供研究使用;資料庫則保存相關的數位資訊。血液可用於取得 DNA,其中含有基因指令;也可取得血清,也就是血液凝固後留下的液體。研究人員可將這些檢體與個人的疾病及醫療照護資訊一併分析。
10 月公告指出,捐贈的血液及尿液會保存於由疾病管理廳營運的韓國國家生物資料庫。將檢體與紀錄串聯,可讓研究人員探討基因差異與疾病、治療之間的關聯。
精準醫療是依據個人的特定特徵選擇預防或治療方式。藥物基因體學是計畫預定的用途之一,研究基因差異如何影響藥物反應,包括藥物是否可能有效或造成不良反應。
百萬人目標如何分配
政府計畫在 2028 年前收集 77.2 萬人的資料,並於 2032 年前達到 100 萬人。第一階段招募目標分為三組:
- 一般參與者 58.5 萬人。
- 重症患者 14 萬人。
- 罕見疾病患者 4.7 萬人。
三組合計 77.2 萬人。重症或罕見疾病患者共占 18.7 萬個名額,約為第一階段招募目標的 24%;一般參與者約占 76%。
納入罹患及未罹患目標疾病的人,可讓研究人員比較不同族群。他們可檢視與特定疾病相關的基因變異、臨床病史及生物測量數據。罕見疾病組也能建立專門的資料集,收錄患者可能分散在不同醫院的疾病資訊。
預計首次釋出的約 12 萬筆紀錄,約相當於最終百萬人目標的 12%。因此,在持續招募及準備資料的同時,研究人員就能先使用部分資源展開研究。
為何資料收集與研究取用的進度不同
完成登錄只是研究資料準備工作的起點。紀錄必須經過查核、整理及標準化,才能將不同機構收集的資訊放在一起分析。同一項測量或診斷,在整個資料集中必須具有一致的定義。
10 月公告指出,首批釋出的資料將涵蓋前一年底以前收集、且已完成標準化及清理的資訊。公告稱研究平台已於前一週完成,目前正進行品質檢查及測試;截至公告當年底收集的資料,則預定於次年釋出。
2025 年 12 月的資料更詳細說明了先前的執行時程。招募工作因 38 個招募機構的系統問題及其他因素延宕,直到 2025 年 3 月才正式展開。原先預期 2025 年底前收集 19 萬至 20 萬人的資料,後來下修至約 12 萬人。
當時每天招募人數約為 800 至 900 人。白龍民估計,要在 2032 年前達到 100 萬名參與者,平均每天須招募 1,000 名捐贈者。換算下來,當時公布的每日招募速度是其基準的 80% 至 90%;資料清理與標準化也仍是另一項重大工作。
計畫推動時程
這項計畫結合新的整合資料工作,以及多年來建立的生物檢體收藏與機構。各項里程碑呈現了既有基礎,也顯示研究人員使用新資源前仍須完成的工作。
- 2001 年:韓國基因體與流行病學研究開始收集以人口為基礎的人體生物資源。
- 2008 年:韓國生物資料庫計畫啟動,以支援檢體的國家級管理及生醫研究。
- 2025 年 3 月:經歷執行延宕後,整合計畫正式展開招募。
- 2025 年 12 月 1 日:約 11 萬人被記錄為已提供臨床與基因體資料。
- 2026 年規劃時程:預計第三季完成平台,第四季釋出首批資料集。
- 10 月 15 日公告,年份未註明:擴大參與資格,並宣布 11 月釋出約 12 萬人的資料。
- 2028 年及 2032 年:招募目標分別為 77.2 萬人及 100 萬人。
韓國生物資料庫網絡的機構背景頁面介紹了自 2013 年起參與計畫的 17 家大學醫院區域生物資料庫及 2 個合作機構。該頁面也引用《生物倫理與安全法》第 2 條第 11 款對人體生物資源的定義,包括組織、血液、DNA 及蛋白質。
這個既有網絡在生物檢體的收集、管理及分送方面累積了經驗。整合計畫則進一步將多種資訊串聯,建置共享研究資源。
哪些人能使用這些資訊?
大學、醫療機構及企業的研究人員可提交研究計畫,申請使用資料。10 月公告指出,獲准使用者將在安全的封閉平台內分析資料。
敏感的基因體及臨床資訊會留在該環境內,只有分析結果可以帶出。實際上,研究人員須將研究問題及分析工具帶到資料所在的平台,而非取得不受限制的參與者紀錄副本。
計畫透過 BI KO 推動;該辦公室隸屬於韓國保健產業振興院。其組織包括秘書處、資料庫及生物資料庫。資料庫負責整合數位資訊並管理其研究用途;生物資料庫則負責管理由檢體及相關資訊取得的材料。
專家委員會就資料品質與安全、倫理與法律議題、資料取用與使用、生物分析及國際合作提供建議。這些委員會的職責連結科學研究工作,以及如何處理敏感資訊、哪些人可以研究這些資訊等決策。
醫療人工智慧將如何運用這些資料
政府希望這項資源能支援其所稱的「南韓自主醫療人工智慧」,也就是在韓國掌控的資料及研究基礎設施上,建立國內發展醫療人工智慧的能力。公告列出的應用還包括先進醫療器材、新藥及疾病生物標記的發現。
生物標記是可測量的生物特徵,有助研究人員辨識或追蹤疾病。透過一併研究檢體與醫療紀錄,研究人員可能找出與特定疾病或治療反應相關的基因或其他生物模式。
國家人工智慧戰略委員會副主席河正宇談到這項計畫與國家在醫療及藥物開發方面的目標時表示:
我希望以人工智慧創新為基礎,讓南韓在精準醫療及新藥開發方面的能力再上層樓。
2025 年 12 月的規劃資料也提到,計畫將於 2026 年底前訂定人工智慧模型開發方案。可能方案包括大型語言模型或支援研究的人工智慧代理。大型語言模型可處理並生成語言;人工智慧代理則能運用軟體工具執行一連串任務。兩者都在評估是否作為平台內的研究工具。
參與者如何共享成果
保健福祉部長鄭恩敬在 10 月活動中將生物資料庫描述為全民共享的國家資源:
國家整合生物大數據,是透過全民參與完成的公共資產。
政府承諾,廣泛且安全的研究使用將透過更好的藥物、醫療器材及更個人化的照護,轉化為全民受益的成果。企業也列入可能獲准使用資料的對象,因此這項資源除了與醫院及大學研究相關,也適用於商業開發。
2025 年 12 月的計畫則提出一項對罕見疾病參與者更直接的益處。計畫打算從 2026 年起,提供主治醫師可用於提出診斷申報的報告,協助捐贈者接受照護。這讓罕見疾病資訊的收集與提供資料者的治療需求直接連結。
眼前的執行工作仍很具體:招募志願者、整理出一致的紀錄、完成資料取用審查,並確保研究平台可供使用。百萬人目標有賴這些工作同步推進,才能讓捐贈的檢體及資訊成為研究人員實際可用的資源。
重點整理
- 南韓已將生物資料庫參與資格擴大至接受例行健康檢查者以外的民眾。
- 計畫目標是在 2028 年前招募 77.2 萬人、2032 年前達到 100 萬人,並規劃至 2028 年投入 6,600 億韓元。
- 第一階段招募目標包括 58.5 萬名一般參與者、14 萬名重症患者及 4.7 萬名罕見疾病患者。
- 獲准的大學、醫院及企業研究人員將透過封閉平台使用資料,僅能匯出分析結果。
- 10 月公告預定於 11 月釋出資料;2025 年 12 月的資料則指出,首次開放取用的時間落在 2026 年底。10 月公告未註明年份。
- 計畫預定用途包括醫療人工智慧、藥物開發、疾病生物標記,以及為個別患者量身打造的治療。