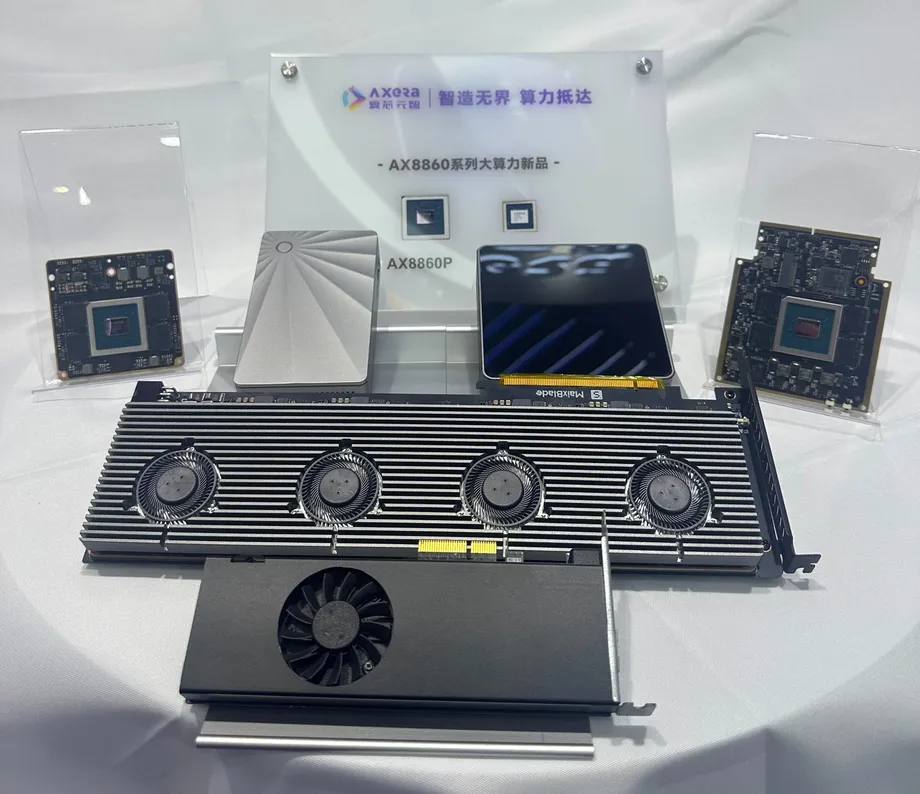
小型中國 AI 電腦瞄準高價競爭對手
Sipeed 為搭載 128 GB 記憶體的 MaixStation 電腦設定約 3,999 美元的目標價格,核心採用中國晶片廠商 Axera 的 AX8860P。這款電腦尺寸僅 11 × 11 × 3 公分,標榜可在本機執行大型 AI 模型,典型功耗為 40 瓦。它鎖定的競爭對手是 Nvidia 的 DGX Spark,這款小型 AI 系統搭載 128 GB 記憶體,售價約 6,950 美元。
目錄
Axera 於 2026 年 10 月 13 日在上海的一場工業展覽會上發表這款晶片,Sipeed 也同場展示 MaixStation。最初公布的效能相當亮眼:執行 270 億參數的 Qwen 模型時,提示詞處理速度比 DGX Spark 快 25%,答案生成速度快 30%,價格約為對手的一半。
Sipeed 的 MaixStation 產品頁面目前提供更詳細的資訊。頁面列出執行 Qwen3.8-27B 時,提示詞預填速度為每秒 592 至 677 個 token,答案生成速度為每秒 6 至 7 個 token。這些數字低於發表會前後流傳的數據;官方上市計畫則是在 2026 年底於 Kickstarter 發起募資。
這款產品的吸引力很實際:小型電腦若能提供大量記憶體,開發者、辦公室與個人使用者就有機會在不租用雲端運算資源或購買多張顯示卡的情況下,執行能力強大的模型。然而,購買決策不只取決於晶片規格,最終軟體、實測效能與交貨時程同樣重要。
Axera 在 AX8860P 中採用的設計
AX8860 系列採用 6 奈米製程,結合 16 個 Arm Cortex-A55 CPU 核心與專用神經網路處理器(NPU)。NPU 是專為執行 AI 模型所需的重複運算而設計的處理器。Axera 與 Sipeed 宣稱,使用 FP4 時,其效能最高可達每秒 256 兆次運算,通常簡稱為 256 TOPS。
FP4 以 4 位元精度儲存數值。減少位元數可降低模型所需的記憶體,並加快運算速度,但模型與軟體必須支援這種格式。Axera 的數據指的是密集運算,並未採用「稀疏性」技術,假設可跳過部分數值來計算。
這款晶片支援 PCIe 5.0,記憶體介面寬度為 256 位元。Sipeed 指定採用 LPDDR5X-8533 記憶體,每個模組最高可達 128 GB,頻寬為每秒 273 GB。Maix-V 模組尺寸為 78 × 78 毫米,使用 LPCAMM2 連接器。
Cortex-A55 核心負責執行作業系統與支援性工作,NPU 則用於承擔主要 AI 工作負載。Nvidia 的 DGX Spark 配備 20 個 Arm 核心,包括效能更強的 Cortex-X925 核心;競爭對手 AMD Ryzen AI Halo 系列則採用 Zen 5 CPU。因此,若使用者打算將 AI 推論與大量一般運算工作結合,除了加速器之外,還有更多面向需要比較。
為何 128 GB 記憶體比 TOPS 標稱數字更重要
語言模型需要記憶體存放代表訓練成果的數值權重,也需要空間儲存模型回應請求時產生的工作資料。加速器速度再快,若記憶體不足,仍可能必須把模型分散到多台裝置,或搬移至速度較慢的儲存裝置。
MaixStation 規劃的 128 GB 配置,記憶體容量與較大的 DGX Spark 同級,兩者標示的頻寬都是每秒 273 GB。AMD Ryzen AI Halo 系列則包含一款 128 GB 配置,頻寬約每秒 256 GB;較高價的版本配備 192 GB,頻寬為每秒 273 GB。
容量決定能裝進多少資料,頻寬則決定資料能以多快的速度傳送至處理器。密集型語言模型在一般生成過程中,每產生一個新 token,都需要讀取大量模型資料。Token 是文字的基本單位,有時是一個詞,有時則只是詞的一部分。
因此,Sipeed 主張,有效運用記憶體可讓其 256 TOPS 處理器與 Nvidia 標示數字更高的運算能力競爭。DGX Spark 標示的 FP4 效能約為 1,000 TOPS,採用了稀疏性技術;其密集 FP4 效能約為每秒 500 兆次運算。實際應用速度也取決於軟體能否有效維持硬體運作。
官方基準測試頁面呈現較有限的效能表現
Sipeed 將測試分為預填(prefill)與解碼(decode)兩個階段:預填是模型處理使用者提示詞的階段,解碼則是模型生成答案的階段。預填速度越快,通常能縮短使用者開始看到答案前的等待時間,尤其是處理長篇文件時;解碼速度越快,則能在開始生成後更迅速地呈現答案。
針對採用密集 FP4 的 Qwen3.8-27B,官方頁面列出的 MaixStation 預填速度為每秒 592 至 677 個 token,DGX Spark 為 550 個,換算後領先約 8% 至 23%。MaixStation 標示的解碼速度為每秒 6 至 7 個 token,但官方圖表提供的文字資料未列出該模型在 DGX Spark 上的解碼基準數字。
針對混合專家模型 Qwen3.6-35B-A3B,Sipeed 列出的預填速度為每秒 2,664 至 3,256 個 token,DGX Spark 為 2,368 個,換算後領先約 13% 至 38%。解碼速度方面,MaixStation 為每秒 34 至 37 個 token,DGX Spark 為 34 個,從持平到領先約 9% 不等。
混合專家模型每次處理 token 時,只會啟用部分網路。這有助於解釋為何它的生成速度可能遠高於參數總量相近的密集型模型。兩種模型每個 token 所需的運算量不同。
Sipeed 表示,頁面列出的數據是目前較保守的實測結果,AX8860P 仍在調校中。圖表註明測試採用 FP4,並停用多 token 預測(MTP)。MTP 是一種藉由同時預測多個後續 token 來加快生成速度的技術。
先前的速度說法為何需要審慎比較
Sipeed 先前公布的基準測試數據較高:Qwen3.8-27B 的預填速度為每秒 1,400 至 1,600 個 token,解碼速度為每秒 15 至 17 個 token;DGX Spark 的基準數據分別為 1,300 個與 13 個。混合專家模型的預填速度則為每秒 6,300 至 7,700 個 token,解碼速度為每秒 80 至 88 個;DGX Spark 分別為 5,600 個與 80 個。Sipeed 之後也公布另一組比較,稱 MaixStation 在兩個階段都領先約 10%,並表示顯示更大差距的較新測試結果並非官方數據。
官方頁面上的絕對速度較低,因此測試條件尤其值得留意。提示詞長度、同時處理的請求數量、數值格式、執行環境軟體與驅動程式版本,都可能影響結果。報導引用的 DGX Spark 獨立測試中,執行 Qwen3.8-27B 且未使用推測解碼時,速度約為每秒 11.5 至 11.6 個 token;預填速度則依軟體不同,介於每秒 840 至 1,900 個 token。
簡單的記憶體計算,說明了為何先前宣稱每秒 17 個 token 的速度受到關注。若執行中的模型約占用 16 GB,以每秒 273 GB 的頻寬除以 16 GB,理論上約為每秒 17 個 token,還未計入其他記憶體傳輸。若要達到這個速度,必須極有效地運用標示的頻寬。
模型實際占用的記憶體也很重要。27 億個參數各以 4 位元儲存,權重本身約占 13.5 GB;加上數值縮放資料與其他儲存需求,實際工作空間還會增加。若有詳細且可重複的測試,買家就能將速度數據與特定模型配置對照。
口袋大小的機箱,搭配標準儲存裝置
MaixStation 標示尺寸換算後的體積為 363 立方公分。Sipeed 將其與體積為 1,125 立方公分的 DGX Spark 比較,表示其規劃中的機箱體積約為對方的三分之一。公司稱,只要搭配額定功率 65 瓦的合適行動電源,也能透過 USB-C 為電腦供電。
官方頁面標示 MaixStation 的典型功耗為 40 瓦,DGX Spark 則為 120 瓦。這是 Sipeed 所稱的典型負載。AX8860 最初相關報導也將 40 瓦列為專用模組的功耗,因此未來測試若能說明功耗數據的測量範圍,會更有參考價值。
連接埠與介面包括 10G SFP+ 網路、USB-C、MCIO 8i 連接器,以及可安裝 SSD 的標準 M.2 2280 插槽。這種儲存格式讓買家能以熟悉的方式擴充空間,以存放可能迅速占用數百 GB 的模型檔案。
Axera 的硬體規劃不只涵蓋小型桌上型電腦,還包括模組、單晶片 PCIe 擴充卡,以及搭載四顆晶片、四個風扇與標準 8-pin 電源連接器的擴充卡。Sipeed 表示,MaixStation Pro 與 MaixBlade 的配置可提供 512 GB 或以上的記憶體。
更多晶片可提升容量,但擴充效能仍待驗證
Sipeed 表示,MaixStation 可在不使用外接交換器的情況下連接最多八個節點,晶片間連線頻寬為每秒 256 gigabits,並可擴充至每秒 384 gigabits。DGX Spark 透過每秒 200 gigabits 的連線串接系統,四台 Spark 組成的配置則需要外接交換器。
gigabits 與 gigabytes 的差異很重要。每秒 256 gigabits 的連線,換算後原始速度為每秒 32 gigabytes,還未扣除額外負載。每秒 273 gigabytes 的記憶體頻寬描述的是各電腦內部另一條速度快得多的連線。
Axera 列出雙晶片合計 512 TOPS、四晶片合計 1,024 TOPS,並宣稱擴充效率約為 80%。四晶片擴充數據來自實驗室模擬。將模型分散至多個處理器,也會增加通訊與同步工作,因此應用程式的速度不只取決於將各晶片的峰值運算效能相加。
Axera 的產品路線圖列出 AX8950,效能最高可達 500 TOPS;AX8970 則超過 700 TOPS。這些規劃中的處理器將提供後續升級選項,但 MaixStation 目前的主打賣點仍取決於 AX8860P 與其軟體。
軟體承諾是日常使用體驗的關鍵
Sipeed 列出的軟體包括 Debian 13 與 Linux 6.18,並支援 vLLM、SGLang、PyTorch、llama.cpp 和 Ollama。這些工具有助於載入模型、提供請求服務,並讓 AI 應用程式連接硬體。公司也標榜提供相容於 OpenAI 與 Anthropic 的 API,讓現有應用程式能向本機裝置傳送請求。
Sipeed 在產品常見問題中說明,這些熟悉的框架名稱所對應的功能,是透過為 Axera 硬體編寫的軟體執行:
SGLang 和 vLLM 透過客製化硬體加速後端執行,其核心運算程式以 AXDSL 編寫。
核心運算程式(kernel)是負責在加速器上執行核心運算的小型軟體。Sipeed 表示,使用者可直接載入 Hugging Face 支援的模型;新的模型架構則可能需要以 AXDSL 編寫核心運算程式。公司承諾公開發布相關程式與開發工具,並表示正著手開放 AX8860 軟體開發套件。
公司標榜電腦開機後即可使用模型與瀏覽器介面。建議用途包括程式開發代理、文件處理、影片生成與機器人。PCIe 擴充卡將先支援 Linux 主機;Windows 支援則視需求而定。產品發表時,NPU 工具鏈預計於 10 月底推出。
價格與交貨時程如今都與募資活動掛鉤
Sipeed 為 128 GB 版本設定的預期價格為 3,999 美元,約比售價 6,950 美元的 DGX Spark 低 2,951 美元,也就是便宜約 42%。這是相當大的折扣,但不到對方的一半。MaixStation 的價格也將接近搭載 128 GB 記憶體的 AMD Ryzen AI Halo,後者售價約為 3,999.99 美元。
推出時程已從最初預期的 2026 年內交貨有所調整。目前已開放預約,但官方常見問題將 Kickstarter 募資時間訂在 2026 年底。Sipeed 表示,目標是在募資活動結束後三個月內出貨。
- 2026 年 10 月 13 日:Axera 在上海發表 AX8860 系列,Sipeed 同場展示 MaixStation。
- 2026 年 10 月底:Sipeed 預計推出 NPU 工具鏈。
- 2026 年底:Sipeed 計畫在 Kickstarter 發起 MaixStation 募資活動。
- 募資活動結束後三個月內:Sipeed 宣稱的出貨目標。
Sipeed 尚未確認最終零售價格、確切交貨日期,也沒有 MaixStation 經獨立驗證的效能數據。產能、支援安排,以及 512 GB Pro 版本的價格與推出時程也都尚未確定。公司計畫在募資期間提供遠端使用機會與評測機,讓有意購買者能進一步檢視相關說法。
重點摘要
- MaixStation 目標價格約為 3,999 美元,配備 128 GB 記憶體,搭載 Axera AX8860P 處理器;其密集 FP4 效能標示為 256 TOPS。
- Sipeed 標示的記憶體頻寬為每秒 273 GB,典型功耗為 40 瓦,機箱尺寸為 11 × 11 × 3 公分。
- 官方基準測試頁面列出的絕對速度低於先前公布的數據,實際結果則會依模型與處理階段而異。
- 軟體支援仰賴 Axera 客製化加速後端;公司承諾公開發布開發工具與更多程式碼。
- Kickstarter 募資計畫訂於 2026 年底推出,Sipeed 表示目標是在活動結束後三個月內出貨。
- 獨立測試、最終價格與交貨承諾,將決定這套系統與 Nvidia、AMD 競品相比的實際表現。