三家記憶體供應商採用共同製造方案
根據 2026 年 10 月 18 日發布的業界消息,Nvidia 已要求三星電子、SK 海力士與美光,為新一代客製化高頻寬記憶體的基底晶粒採用台積電 3 奈米製程。據報導,三星 Device Solutions 部門經內部審查後接受這項要求,讓其台灣晶圓代工競爭對手參與三星過去一向自行負責的記憶體製造環節。
目錄
這款名為 NVHBM 的產品以第七代高頻寬記憶體 HBM4E 為基礎。Nvidia 也希望供應商在記憶體晶粒上採用第六代 DRAM 製程技術,稱為 1c。此舉旨在讓不同供應商的記憶體運作表現更一致,並減少核准各家產品所需的工程作業。
三星此番決定,將與台積電既有的合作關係從封裝相容性延伸至 HBM 製造。四年前,兩家公司曾合作確保三星記憶體能透過台積電的封裝技術連接圖形處理器。如今在記憶體堆疊中生產關鍵晶片,則讓雙方合作更進一步。
Nvidia 的提案也改變了基底晶粒的功能。NVHBM 將記憶體控制器,也就是負責引導資料流動的電路,從主處理器移至記憶體堆疊底部。這使基底晶粒成為運算系統中更重要的一部分,而不再只是記憶體與處理器之間的連接元件。
對三星而言,接受這種架構代表將過去合併處理的兩項決策分開:負責儲存資訊的記憶體由誰製造,以及管理記憶體與處理器連接的邏輯晶片由誰生產。三星仍會供應記憶體,而指定的基底晶粒則由台積電製造。
記憶體堆疊內部有哪些變化?
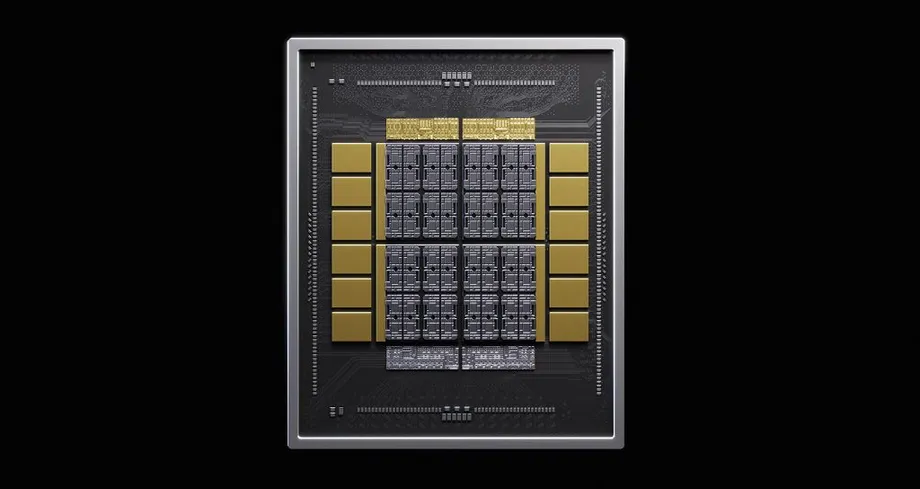
HBM 會將多個記憶體晶粒堆疊在強大處理器旁。這種堆疊設計讓大量資料能在短距離內傳輸,有助於為 AI 加速器的運算單元提供所需資訊。晶粒是含有電子電路的單一矽片。
核心晶粒負責儲存資料。基底晶粒位於其下方,負責連接與邏輯功能。傳統架構會將記憶體控制器保留在主加速器晶粒上。NVHBM 則將控制器移至基底晶粒,騰出處理器上的空間供其他電路使用。
Nvidia 也採用客製化實體介面,稱為 PHY,來連接晶片。PHY 是負責傳送與接收電訊號的電路。NVHBM 的技術說明指出,它以較窄的專有序列化連接取代標準 HBM 所採用的寬幅平行介面,透過較少的連接以更高速度傳送資料。
傳統介面的規模有助於理解這項設計的吸引力。HBM4 有 32 個通道,每個通道寬 64 位元,總寬度達 2,048 位元。管理這些連接需要大量電路,以及晶片間複雜的佈線。NVHBM 的目標是減輕這項負擔,並簡化晶片下方連接層「中介層」上的佈線。
Nvidia 透過 NVLink Fusion,將 NVHBM 作為客製化矽晶合作夥伴可採用的建構元件。標準 HBM 仍屬於另一項獨立產品類別。選用 NVHBM 的合作夥伴,會在自家加速器系統中採用 Nvidia 指定的控制器與連接設計。
Nvidia 為何要求供應商採用相同製程
Nvidia 提議的製造方案結合台積電 3 奈米邏輯製程,以及用於記憶體層的先進 DRAM 製程。邏輯晶片與 DRAM 的用途不同,製造方式也不同。3 奈米代表一代邏輯製造技術,1c 則代表一代 DRAM 技術。
三星、SK 海力士與美光各自擁有不同的設計與生產方法。當加速器開發商希望向多家公司採購記憶體時,這些差異可能增加額外測試需求。採用共同的基底晶粒製程,可為開發商提供更一致的起點。
驗證是指檢查處理器、記憶體與封裝能否在預定的速度、功耗與可靠度下協同運作。若不同廠商採用不同實作方式,就得重複進行這些作業,耗費工程時間。Nvidia 提出這項方案,是希望在更換記憶體供應商時,減少各自所需的整合工作。
美光將即將推出的 DRAM 世代稱為 1-gamma,整體而言大致相當於三星與 SK 海力士術語中的 1c 世代。因此,統一規格是整合不同公司命名的製程世代,而不是讓所有供應商的記憶體製程完全相同。
台積電將成為彼此競爭的記憶體產品共同的製造夥伴。這種安排可能簡化 Nvidia 在不同供應商產品上的實作,同時也讓重要製程集中於一家晶圓代工廠。三星評估備用製造方案,反映出確保基底晶粒供應充足的實際重要性。
三星仍將自有工廠納入布局
三星計畫在標準 HBM 產品上維持整合式製造模式。三星的 HBM4 與 HBM4E 產品,基底晶粒採用自家的 4 奈米製程,核心晶粒則採用 1c 製程。記憶體層在南韓華城與平澤廠區製造。
三星於 2026 年稍早開始量產 HBM4;截至 10 月相關消息發布時,HBM4E 正在進行量產認證。認證是用來確認產品是否符合所需標準,並能穩定量產的測試階段。
三星預計也會以整合式模式,為包括 AMD 在內的其他客戶生產客製化 HBM。因此,NVHBM 的決定是針對 Nvidia 的特定需求,並非三星全面停止內部製造基底晶粒。
據預期,三星記憶體事業部將主導台積電製造基底晶粒的設計與最佳化支援。這將改變三星內部的分工;過去由 System LSI 與晶圓代工事業部共同參與內部供應的基底晶粒。
三星也正在評估,如果需求超出台積電產能,自家晶圓代工部門是否能製造 NVHBM 基底晶粒。這項備援方案可保留另一種生產選擇,不過據報導,Nvidia 目前的規格仍以台積電 3 奈米製程為核心。
美光與 SK 海力士採取不同路線
美光的轉變不只涉及 Nvidia 的客製化產品。美光表示,與 Nvidia 合作開發的 NVHBM,以及標準 HBM4E,都將採用外部晶圓代工廠製造的基底晶粒。預計將由台積電負責製造。
在 HBM4 方面,美光將採用 1-beta 製程製造的記憶體晶粒,搭配內部製造的基底晶粒。到了 HBM4E,記憶體層改用 1-gamma 製程,基底晶粒生產也移出美光自有工廠。因此,美光同時調整堆疊中的兩大部分,一方面採用更新的記憶體製程,另一方面則改由外部夥伴製造邏輯晶片。
美光營運長 Manish Bhatia 預期,NVHBM 將帶來更高的平均售價與更高的利潤率。他的理由是,HBM 本來就以溢價銷售,而客製化所需的額外工作與功能會創造更多價值。因此,即使將基底晶粒外包,美光仍預期獲利能力會提升。
SK 海力士目前已採用台積電 12 奈米邏輯製程製造 HBM4 基底晶粒。業界消息指出,台積電 3 奈米製程正優先用於 HBM4E 與未來的客製化 HBM。此舉將把更先進的邏輯製程導入一項責任日益增加的元件。
SK 海力士今年稍早也在 Nvidia 的 GTC 活動上展示了基於 Stream DQ 技術的客製化 HBM 概念。這項概念著重於持續管理資料並將資料提供給處理器。三家供應商的共同方向,是讓基底晶粒在資料傳輸中扮演更積極的角色。
Nvidia 的效能數據代表什麼
Nvidia 表示,與標準 HBM4E 相比,NVHBM 每個堆疊可提供最高多 30% 的頻寬,HBM 功耗則可降低 15%。頻寬衡量的是特定時間內能傳輸多少資料。當 AI 處理器受限於等待記憶體提供資訊時,更高的頻寬可能有所助益。
簡單來說,若標準 HBM4E 堆疊在特定時間內傳輸 100 單位資料,Nvidia 宣稱的最高提升幅度可使其增至 130 單位。若作為比較的記憶體耗電量為 100 單位,宣稱的降幅則會使 HBM 功耗降至 85 單位。這些例子是將百分比換算成具體數字,並非描述特定上市產品。
Nvidia 也表示,此設計可釋出 XPU 運算晶粒最多 25% 的面積。XPU 是運算處理器的廣義名稱,包括客製化 AI 加速器。將記憶體電路移開後,設計人員便能把更多矽晶面積分配給運算功能。
另一則 Nvidia 簡報相關消息指出,主晶粒的運算能力最多可增加 30%。這衡量的是潛在運算資源,而 25% 指的是架構變更所釋出的矽晶面積。設計人員仍須決定如何運用騰出的空間。
據稱,客製化 PHY 可使該介面佔用的面積最多減少 67%。一項技術評估是根據接腳數量減少推算出這個幅度。Nvidia 對頻寬、功耗與面積所做的整體比較,都以標準 HBM4E 為基準;當時該世代產品尚未上市。
對 AI 服務而言,若瓶頸在記憶體,更快的資料傳輸有助於加快回應生成速度。較低的記憶體功耗則能讓系統設計人員在電力預算內保有更多空間。對整台伺服器的影響,除了記憶體之外,也取決於處理器、工作負載、網路與散熱。
Amazon 將記憶體納入 Nvidia 更廣泛的平台
Amazon 旗下 Annapurna Labs 是首家公布的 NVHBM 合作夥伴。這家晶片設計公司為 Amazon Web Services 開發 Trainium 加速器,讓 Nvidia 得以向一家同時自行開發 AI 處理器的公司供應記憶體技術。
Annapurna Labs 副總裁 Nafea Bshara 在公告附帶的談話中說明合作目的:
我們期待這項技術合作能為 AWS 未來的基礎設施設計帶來助益。
預計 Annapurna 的 Trainium 4 將支援 NVLink Fusion。關於 NVHBM 推出的消息指出,這項技術可能隨 Trainium 4 或後續世代導入;Amazon 採用 NVHBM 的確切晶片世代與商用日期,尚未對外確定。
NVLink Fusion 讓合作夥伴能使用 NVLink Chiplet、NVLink-C2C、NVLink Switch,以及 MGX 系統與機架等技術。這些技術提供連接方式與系統設計,讓客製化處理器能納入 Nvidia 的運算基礎設施。NVHBM 則將記憶體子系統加入這套技術組合。
據報導,MediaTek 在 NVHBM 公布五天後採用 NVLink Fusion,並計畫將其提供給自家的 XPU 客戶。這讓 Nvidia 在客製化加速器專案中多了一條拓展途徑;這個市場也有 Broadcom 與 Marvell 競爭。Marvell 曾在 2024 年 12 月介紹相近的記憶體控制功能移轉方案,因此客戶採用與系統整合將是競爭的重要環節。
這項轉變如何發展
NVHBM 的發展結合了架構、供應商關係與客戶採用方面的變化。從發展順序可看出三星 10 月決策的重要性:Nvidia 先提出共同設計,記憶體製造商接著必須決定如何生產。
- 2024 年 12 月:Marvell 提出類似概念,採取不同的記憶體控制功能配置方式。
- 2026 年稍早:三星開始量產 HBM4,SK 海力士則在 GTC 展示 Stream DQ 客製化 HBM 概念。
- 2026 年 8 月 26 日:Nvidia 宣布 NVHBM 將加入 NVLink Fusion,並點名 Annapurna Labs 為首家合作夥伴。
- 五天後:據報導,MediaTek 採用 NVLink Fusion,並計畫提供給旗下 XPU 客戶。
- 2026 年 10 月 18 日:業界消息指出,Nvidia 要求基底晶粒採用台積電 3 奈米製程,三星則在內部審查後接受。
三星的決定讓製造計畫更接近 Nvidia 在不同記憶體供應商間實現一致方案的目標。同時,三星持續投資自製基底晶粒,為標準 HBM 以及供應其他客戶的客製化產品保留另一條路線。
重點整理
- 據報導,Nvidia 希望三星、SK 海力士與美光以台積電 3 奈米製程製造 NVHBM 基底晶粒。
- NVHBM 將記憶體控制器從主處理器移至 HBM 堆疊的基底晶粒。
- 三星接受這項要求,但計畫在標準 HBM 與其他客製化產品上保留內部製造。
- 美光計畫為 NVHBM 與標準 HBM4E 外包基底晶粒製造;SK 海力士則已與台積電合作生產 HBM4。
- Nvidia 宣稱,與標準 HBM4E 相比,NVHBM 頻寬最高增加 30%,HBM 功耗降低 15%。
- Amazon 旗下 Annapurna Labs 是首家公布的合作夥伴;三星則正在評估自家晶圓代工廠作為可能的生產備援。