組裝線加速,記憶體供應成焦點
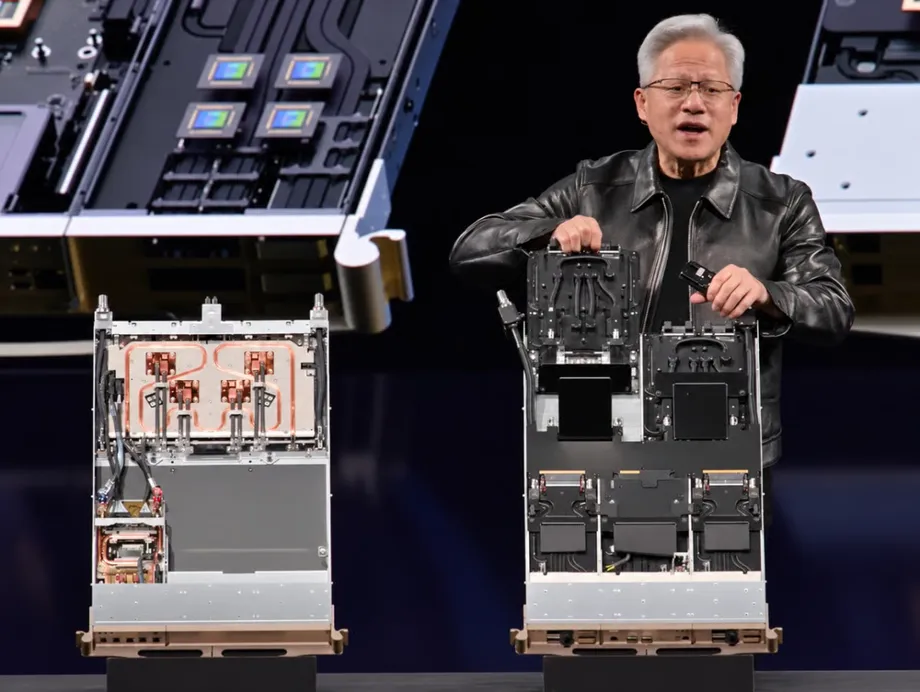
Nvidia已開始全面量產Vera Rubin人工智慧運算平台。執行長黃仁勳表示,現在組裝一個伺服器節點不到五分鐘,相較之下,前一代Grace Blackwell需要兩小時。這項改變有望加快伺服器製造,同時也會增加對三星電子、SK海力士和美光所供應先進記憶體的需求。
目錄
黃仁勳在GTC Berlin 2026展示Vera Rubin節點,並形容其設計不含纜線或電線,且採用100%液冷。Grace Blackwell則有80%的系統採用液冷,組裝工作也繁重得多。
組裝時間的比較顯示,所需時間減少超過95.8%,從120分鐘降至不到五分鐘。對大量建置AI伺服器的企業而言,簡化這個步驟有助設備更快通過工廠。晶片製造、記憶體封裝及完整系統安裝所需時間,仍是整體生產時程的一部分。
三星與SK海力士正競逐由此帶來的HBM4需求。HBM4是第六代高頻寬記憶體。美光也已取得Vera Rubin供應資格,這使得三大HBM製造商全數加入競爭。
與此同時,供應商已開始展示HBM4的下一代產品HBM4E。這些發表顯示兩項相互關聯的壓力:Nvidia希望伺服器更易於組裝,而記憶體製造商則必須在複雜的生產流程中提供更高速度與容量。伺服器組裝越快,穩定可靠的晶片交付就越重要。
Vera Rubin有哪些改變?
伺服器節點是大型運算系統的基本組成單位。Nvidia將這些單位連接起來,讓多個處理器協同處理高難度AI任務,例如訓練模型,或回應大量使用者的請求。
Vera Rubin採用更簡化的組裝設計,減少連接元件所需的作業。黃仁勳拿它與Grace Blackwell比較時,重點在於節點移除了纜線和電線,並改為全面採用液冷。
液冷透過循環流動的液體帶走元件熱量。高效能AI處理器會產生大量熱能,控制溫度有助它們在長時間運作時維持可靠表現。黃仁勳所描述的Vera Rubin系統將這種做法擴大至整套系統。
Nvidia宣布投入生產,代表這項設計已進入製造階段。成品系統交付客戶的速度,也取決於處理器、記憶體、封裝和冷卻設備是否充足。
HBM4為何攸關AI效能
HBM會將多顆記憶體晶片垂直堆疊,放在AI處理器旁。穿過矽晶片的微小連接可讓資料在各層之間傳輸,再透過共用的連接介面將堆疊與處理器相連,讓處理器能快速存取資訊。
AI處理器需要這種存取能力,因為運算需要持續取得資料。如果記憶體無法及時供應資訊,效能強大的處理器也可能得停下來等待。頻寬代表每秒可傳輸多少資料;容量則代表一次能容納多少資料。
HBM4將資料介面拓寬至2,048位元,是上一代的兩倍。三星表示,其12層堆疊的頻寬為每秒2.8TB;美光則表示,目前的HBM4產品頻寬超過每秒2.8TB。
速度與儲存空間同樣重要。訓練AI模型需要對大量資料反覆運算。執行已訓練模型的「推論」也需要記憶體來存放模型,以及正在處理的請求相關資訊。
三星追求速度,SK海力士提升容量
三星HBM4結合第六代1c DRAM製程,以及採用4奈米邏輯製程打造的基礎晶粒。基礎晶粒是記憶體堆疊下方的控制層。三星表示,每個接腳的資料傳輸速率為每秒11.7Gb,在最佳化配置下最高可達每秒13Gb。
三星電子記憶體研發主管黃相俊在公司宣布首批商用出貨時,說明了這項製程選擇:
三星沒有採取沿用現有成熟設計的傳統做法,而是大膽採用1c DRAM和4奈米邏輯製程等最先進技術來打造HBM4,
SK海力士展示的HBM4產品則採取不同路線,使用較成熟的1b DRAM製程,並堆疊16層。該版本容量為48GB,相較之下,三星的12層堆疊容量為36GB。
因此,SK海力士的堆疊多出12GB,容量增加三分之一。額外空間有助系統在處理器附近保留更多工作資料;三星的做法則著重運用較新的製程加快資料傳輸。
長時間對話和複雜的AI任務尤其需要大容量。模型會將請求前文的資訊保存在稱為鍵值快取的暫存空間。使用者提出的請求越長、數量越多,快取就越可能占滿可用記憶體,迫使系統將資訊移至速度較慢的儲存裝置。
SK海力士開發主管安賢曾預測,到2030年,AI基礎設施所需的效能規模可能約為2026年的20倍。他主張開發新記憶體技術,部分原因在於推論系統需要隨時快速存取的資訊量持續增加。
美光擴產,2027年產能已全數預訂
美光於2026年10月中旬在台灣台中啟用第二座先進HBM組裝與測試廠。這座名為AATT2的廠房將增加產能,把單顆記憶體晶片組裝成完整堆疊。
美光總裁暨營運長Manish Bhatia在啟用典禮上談到需求:
2027年所有規劃產能都已售罄,
美光執行長Sanjay Mehrotra在公司6月的財報電話會議上表示,HBM4商用出貨後數月,累計銷售額便突破10億美元。他也表示,12層HBM4的產量提升速度,是HBM3E同等量產爬坡速度的兩倍。
Nvidia的黃仁勳6月證實,三星、SK海力士和美光都已通過HBM4驗證,並開始為Vera Rubin量產。客戶驗證代表供應商的產品已通過客戶要求的系統使用檢查。
美光的目標是在2026年底前,將HBM總產能提升至每月約10萬片晶圓。截至6月,美光在台灣的累計投資已超過新台幣1.6兆元,約合502億美元。
位於苗栗縣的美光銅鑼廠,目標是在2027年年中開始全面出貨產品。該廠生產的晶圓將運送約24公里至AATT2進行組裝與測試,讓生產的兩個階段能在相對短的距離內銜接。
封裝與人力可能限制交付
HBM生產不只是製造可運作的記憶體晶片。製造商必須將矽晶片薄化、製作精密的穿矽連接,再將多層晶片接合在一起。這些步驟若出現瑕疵,就可能降低可用成品堆疊的數量。
堆疊層數越多,需要成功完成的連接與接合作業也越多。因此,三星選擇以較新製程堆疊12層,而SK海力士採用較成熟製程堆疊16層,兩者面對的製造挑戰和產品規格也各不相同。
設備供應商韓美半導體提供熱壓接合機,運用精確控制的熱度與壓力接合各層。SK海力士6月簽署一份價值442億韓元、約3,300萬美元的合約,為清州廠採購升級版TC Bonder 4.5 Griffin設備。韓美半導體預計於2027年推出下一代Wide TC Bonder,供商業使用。
美光在台灣也面臨勞動人力的不確定性。美光桃園工會表示,10月7日有2,012名具投票資格的會員中,1,994人授權發動罷工,約占合資格會員的99%。台中工會的調解排定於10月22日舉行。台灣總統賴清德出席AATT2啟用典禮,並呼籲雙方本於誠意協商。
這些發展使外界關注的不只工廠設備,也包括人力安排。罷工授權代表工會獲准採取工業行動;當時尚未宣布實際罷工或可能造成的交貨中斷。
HBM4E已開始成形
三星和SK海力士在2026年10月14日至16日於首爾COEX舉行的SEDEX 2026展出下一代HBM4E技術。兩家公司也展示Nvidia的Vera Rubin Superchip,凸顯記憶體競賽與Nvidia平台的密切關係。
三星HBM4E採用1c DRAM,以及以4奈米製程打造的基礎晶粒。三星表示,每個接腳的速度最高可達每秒16Gb,頻寬為每秒3.6TB。
相較於三星公布的HBM4頻寬每秒2.8TB,HBM4E增加約29%。三星的12層HBM4E堆疊容量為48GB,比相同層數的HBM4堆疊多三分之一;後者容量為36GB。三星也計畫推出8層、32GB,以及16層、64GB的版本。
SK海力士展示的HBM4E,每個接腳速度最高可達每秒16Gb,並表示與HBM4相比,能源效率將提升逾20%。三星於5月向客戶提供樣品,SK海力士則在6月提供樣品進行效能測試。三星正配合客戶時程推進量產。
製造商將目光投向GPU旁的記憶體之外
三星展示zHBM模型,這種架構將記憶體垂直置於運算晶片上方,而非放在旁邊。縮短兩者之間的距離,可能降低資料傳輸所需的時間與能源。
SK海力士展示高頻寬快閃記憶體(HBF),預期其容量約為現有HBM的10倍。這項技術構想是在高速記憶體和儲存裝置之間增加另一個層級,協助AI系統管理更多資料。
三星也展示可在內部執行部分運算的記憶體。這種做法旨在減少資料傳送至獨立處理器的次數。這些方案都在處理相近的問題:即使運算晶片本身極為快速,資料傳輸仍會耗費時間與電力。
zHBM和HBF仍處於概念與開發階段,商業化時程和客戶採用情況尚未確定。就目前Vera Rubin的生產而言,HBM4製造與交付仍是當務之急。
值得關注的生產里程碑
Nvidia全面投產之前,記憶體驗證、工廠擴建和未來產品展示已持續數月。以下重要里程碑顯示,處理器與記憶體的時程日益緊密相連:
- 2026年初:美光HBM4開始量產。
- 2026年5月至6月:三星和SK海力士向客戶提供HBM4E樣品。
- 2026年6月:黃仁勳證實,三大HBM供應商均已取得供應Vera Rubin的資格並投入生產。
- 2026年10月7日:美光桃園工會授權發動罷工。
- 2026年10月14日至16日:三星和SK海力士在首爾SEDEX展出記憶體技術。
- 2026年10月中旬:美光啟用台中AATT2封裝與測試廠。
- 2026年10月22日:美光台中工會相關調解排定舉行。
- 2027年年中:美光目標從擴建後的銅鑼廠全面出貨產品。
Vera Rubin對記憶體需求增加,三星和SK海力士有望受惠;美光產能已簽約的情況,也顯示市場正激烈爭奪可用供應。客戶需要的是完整系統,因此節點快速組裝也必須搭配充足記憶體、可靠封裝和穩定的工廠運作。
重點整理
- Nvidia表示,Vera Rubin已全面投產,節點組裝時間不到五分鐘,較先前的兩小時大幅縮短。
- 該平台採用全面液冷,並使用由已取得供應資格的三星、SK海力士和美光提供的HBM4。
- 三星的12層HBM4堆疊容量為36GB;SK海力士展示的16層堆疊容量為48GB。
- 美光表示,其台中新HBM廠2027年規劃產能已全數簽約。
- 先進封裝、設備供應和勞資協商,仍是影響交貨時程的實際因素。
- 三星和SK海力士正測試HBM4E,並開發新的AI記憶體配置與架構。