可運作的 GPU,以及高出 5% 的吞吐量宣稱
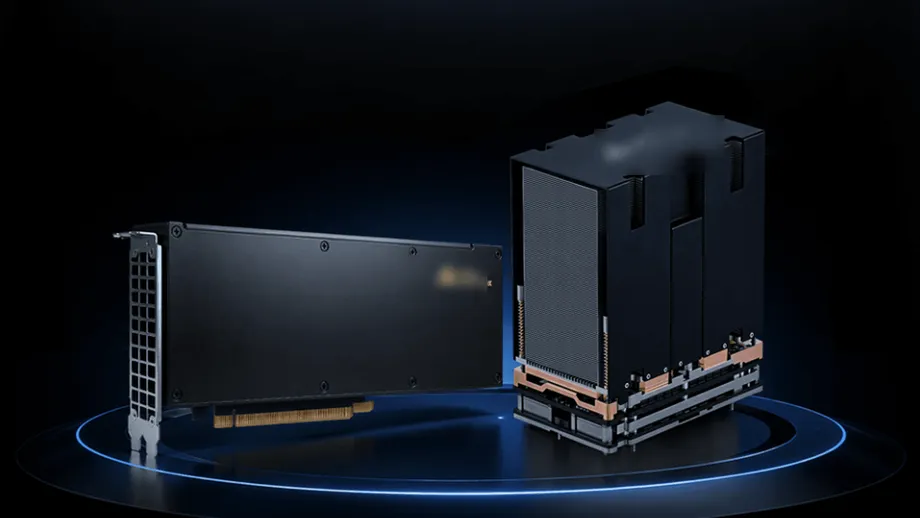
Iluvatar CoreX 在上海公開展示 Tiangai 300 圖形處理器,將其定位為 Nvidia H200 的中國替代方案,並宣稱在一項第三方推論測試中,效能高出 5%。在 2026 年 10 月 28 日的媒體開放日上,該公司也展示了一套配備八張 GPU 的訓練系統,並介紹一座搭載 144 張 GPU 與 18 顆 CPU 的機櫃。
目錄
這項受矚目的比較結果來自上海電氣集團於 7 月完成的測試,據 Iluvatar CoreX 表示,該測試採用將大型語言模型處理分為兩個階段的部署方式。將結果換算為單卡數據後,Tiangai 300 的端到端吞吐量相當於 H200 的 1.05 倍。
吞吐量是指系統在一定時間內完成多少有效工作。以聊天機器人為例,就是每秒生成多少段文字。測試結果若為參照效能的 1.05 倍,代表在該測試條件下,輸出量多出 5%。
該公司將 Tiangai 300 稱為首款在實測中達到 H200 效能的中國通用 GPU。10 月的展示將比較範圍擴及語言模型、影像生成與影片生成;另一場訓練展示則以 Nvidia H100 為參照。
這場活動展示的不只是晶片規格。Iluvatar CoreX 介紹了加速卡、伺服器、高密度機櫃設計、軟體工具,以及在不同處理器類型之間分配 AI 工作的方法。該公司的商業訴求是,這些產品與技術搭配後,能以較低成本、更短等待時間產出實用的 AI 結果。
H200 比較測量的是什麼
上海電氣集團 7 月的測試採用了預填充與解碼分離,通常簡稱 PD 分離。預填充是語言模型讀取使用者要求及相關資料的階段;解碼則是模型逐一產生 token、生成回答的階段。Token 是 AI 系統將文字切分後的小單位。
將這兩個階段分開,系統就能針對讀取與生成採用不同的資源配置。因此,Tiangai 300 的結果反映的是特定部署方式,總體效能則換算為單卡等效數據。
Iluvatar CoreX 尚未公布這項受矚目第三方測試的詳細方法、模型清單或工作負載條件。若要獨立重現測試,還需要這些細節,以及換算方式與軟體設定。成本比較也缺乏已公布的細項;個別加速卡與整座機櫃的記憶體數據也需要進一步釐清。
該公司性能實驗室列出的展示項目,則讓其效能宣稱有更具體的輪廓。不同工作負載的提升幅度各異,從多媒體生成的小幅進步,到推薦吞吐量的大幅增加。對採購者而言,真正相關的比較,是自家服務實際執行的任務。
處理長文件,縮短首次回應時間
據該公司實驗室數據,在 64K 的上下文長度下,Tiangai 300 的注意力機制效能達到 H200 的 1.05 倍。注意力機制能協助模型判斷輸入內容中哪些部分彼此相關。64K 的上下文長度代表模型處理約 64,000 個 token。
在相同上下文規模下執行 GLM-5.3 時,Iluvatar CoreX 宣稱吞吐量達 H200 的 1.15 倍,同時維持相當的使用者體驗。對這項受測的混合專家工作負載而言,吞吐量提升 15%。混合專家模型會將工作分派給選定的專家網路,而不是每個 token 都動用所有網路。
針對上下文長度介於 8K 至 128K 的 AI 代理工作負載,該公司表示,等待第一個輸出 token 的時間約縮短 10% 至 30%。對等待助理讀完長篇文件或處理複雜要求後開始回答的人來說,這項指標相當重要。
影像與影片生成也是展示內容之一。該公司表示,與 H200 相比,多模態生成吞吐量提升約 2% 至 5%。在線上搜尋、廣告與推薦工作負載方面,該公司宣稱推薦推論吞吐量提高 21%,輕量運算延遲則降低 26%。
訓練結果採用不同的 Nvidia 參照產品
訓練展示使用 Qwen3-32B,這款模型約有 320 億個參數,並在一台配備八張 GPU 的伺服器上執行。參數是模型在訓練期間調整、用來學習模式的數值。Iluvatar CoreX 表示,單卡有效吞吐量達 Nvidia H100 的 1.33 倍。
因此,這場訓練展示的吞吐量據稱提升 33%,比較晶片為 H100。活動中其他推論結果則以 H200 為參照。要理解這些數字,必須將兩款參照產品分開看待。
訓練系統以 FP8 精度運作。FP8 使用 8 位元儲存數值,與使用較多位元的格式相比,可減少需要搬移與處理的資料量。AI 訓練軟體必須妥善處理較低精度,才能維持學習品質。
Iluvatar CoreX 也表示,在滿載長時間運作期間,步驟時間變異率為 0.43%,低於以 Hopper 架構為基礎的參照系統的 0.76%。步驟時間是完成一個重複工作單位所需的時間。時間越穩定,營運者就越容易估算繁忙系統能完成多少工作。
從 7 月發布到 10 月展示
Tiangai 300 於 2026 年 7 月的世界人工智慧大會正式亮相。它採用該公司的 Tianshu 架構,搭載新一代 Tensor Core,規格列出的圖形記憶體容量為 144GB。
這款處理器支援純量、向量與張量運算。簡單來說,這些運算分別處理單一數值、數值群組與較大的數學陣列。支援的數值格式包括 FP4、FP8、FP16 與 BF16,讓軟體開發者能依據速度、記憶體用量與數值精度選擇合適格式。
該公司公布的產品里程碑跨越數個月:
- 2026 年 7 月:Tiangai 300 在世界人工智慧大會發布。
- 2026 年 7 月:上海電氣集團完成該公司引用、用於比較 H200 吞吐量的第三方測試。
- 10 月媒體活動前:IXL144 機櫃設計於中國國際工業博覽會亮相。
- 2026 年 10 月 28 日:Iluvatar CoreX 在上海向媒體開放 Tiangai 300 硬體實機展示。
10 月的活動讓產品介紹從架構簡報進一步走向執行指定工作負載的系統。該公司描述的部署範圍,現已從單張加速卡擴展到配備八張加速卡的伺服器,以及更大型的 IXL144 系統。
以 144 張 GPU 打造的機櫃
據 Iluvatar CoreX 表示,IXL144 在一座標準機櫃中整合 144 張 GPU 與 18 顆 CPU,GPU 記憶體總容量約為 10.1TB。該公司稱,這是業界密度最高、設於單一機櫃內的 GPU 超級節點。超級節點會將多個處理器緊密連接,讓它們能協同處理大型工作。
Tiangai 300 每張卡標示的 144GB 規格,與機櫃標示的 10.1TB 總容量之間,仍需要更清楚的配置說明。若以 144 張卡各配 144GB 計算,總量為 20,736GB,尚未考慮容量計算方式的差異。機櫃說明需要列出加速卡配置,以及工作負載實際可用的記憶體容量。
Iluvatar CoreX 估計,與主流國際系統相比,該系統可將每百萬有效 token 的成本降低約 40%。有效 token 指計入有效工作的輸出。對銷售 AI 服務的營運者而言,這項指標可將硬體支出與實際產出的可用內容量連結起來。
降低 40% 代表在參照系統花費 100 單位的工作,使用該系統只需 60 單位。實際節省幅度取決於設備價格、耗電量、軟體、工作負載,以及 GPU 能否持續維持高使用率。
該公司也提出下一代點對點互連引擎的目標:將連接範圍內單次傳輸時間,從 3 至 5 微秒縮短到 1 微秒。若不同 GPU 分別存放模型的不同部分,且必須反覆交換資料,更快的通訊便能派上用場。
在不同晶片間分配 AI 工作
Iluvatar CoreX 的異質部署方法,會將推論的不同部分分派給不同類型的處理器。在其 AFD 分離方案中,Tiangai 300 負責整個預填充階段,以及解碼期間的注意力計算;合作夥伴的 XPU 則負責前饋專家網路。
XPU 是另一類運算加速器的通稱。其基本概念是讓各處理器負責最擅長的工作,再由共同的排程器協調整體任務。前饋網路則負責語言模型內另一項主要的數學運算。
該公司表示,在統一排程下,解碼推論延遲降低 60%。這與受矚目的 H200 吞吐量高出 5% 宣稱,屬於不同的系統配置,衡量的效能指標也不同。
該公司 AI 與加速運算主管 Shan Tianyi 表示,未來的 AI 運算系統,關鍵在於有效調度不同晶片,而非所有任務都依賴同一種處理器。AFD 展示則將這項策略具體呈現為 GPU 與合作夥伴加速器的配置。
軟體宣稱著眼於縮短部署時間
Iluvatar CoreX 也展示了一套名為「AI for AI」的軟體堆疊,旨在自動化部分部署與最佳化工作。該公司表示,環境設定時間從一小時縮短至 10 分鐘,人工操作步驟也從數十項減少至一項。
針對一項大型模型最佳化工作,該公司表示,作業週期從七天縮短至不到兩小時,效能則接近先前的兩倍。這些案例涉及讓模型在硬體上有效運作所需的工程工作。
該公司也宣稱已與 FlyDSL 深度整合。FlyDSL 是一種用於開發 GPU 運算程序的語言。該公司表示,編譯速度提升超過 90%,並稱原本需要 10 人工作一天的流程,如今可由一人在數小時內完成。
處理器不只有運算能力強的硬體,軟體支援同樣重要。模型、數學函式庫與部署工具必須協同運作。軟體展示著重說明,客戶要將新 GPU 轉化為可運作的服務,可能需要投入多少工程資源。
TY1200 將產品訴求延伸至機器人
上海活動也展示了同燿 TY1200。這是另一款處理器,目標應用為 AI PC 與具身智慧,包括能感知並在實體世界行動的機器人。該產品標示的密集運算能力為 300 TOPS,也就是每秒 300 兆次運算。密集運算的計數不會依賴略過涉及零值的計算。
Iluvatar CoreX 宣稱,TY1200 在使用 Qwen3.8-27B 與 Qwen3.6-35B-A3B 的測試中,效能達 Nvidia Thor T5000 的 1.2 倍。針對 Cosmos-R2-2B 與 Cosmos-R2-8B 模型在實體 AI 情境下的測試,該公司表示,效能分別達 Thor T5000 參照值的 158% 與 180%。
該公司也表示,TY1200 可透過 MuJoCo-Warp 執行 GPU 加速的物理模擬。這讓機器人開發系統能模擬動作、訓練控制策略,並在本地端檢驗行為。控制策略是機器人用來決定如何移動的一套學習指令。
該公司列出的應用包括協助民眾就醫的機器人、工業視覺與訪客導引。規劃中的後繼產品 TY2000,標示運算能力目標為 600T。這些產品將該公司的策略從大型 AI 伺服器延伸至使用者與機器附近運作的設備。
重點整理
- Iluvatar CoreX 於 2026 年 10 月 28 日在上海展示 Tiangai 300 硬體。
- 該公司引用上海電氣集團的測試結果,宣稱 Tiangai 300 單卡吞吐量相當於 Nvidia H200 的 1.05 倍。
- 一場使用八張 GPU 執行 Qwen3-32B 的訓練展示,據稱以 FP8 精度達到 H100 單卡吞吐量的 1.33 倍。
- 該公司尚未公布受矚目第三方基準測試的詳細方法。
- IXL144 機櫃搭載 144 張 GPU 與 18 顆 CPU,並宣稱每百萬有效 token 的成本可降低 40%。
- 另一種由 GPU 與 XPU 分工的部署方式,據稱可將解碼延遲降低 60%。
- 活動也介紹了軟體自動化,以及 TY1200 在本地 AI 與機器人模擬方面的應用。