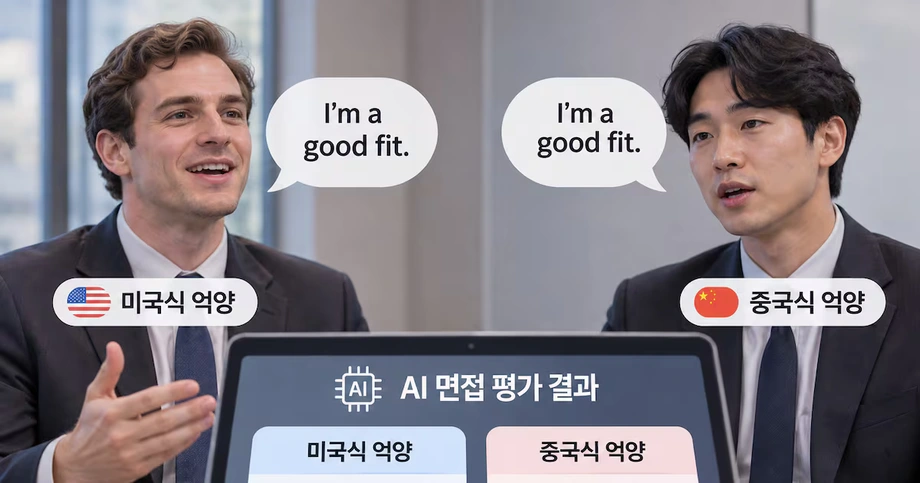
相同的話,不同的分數
華盛頓大學主導的一項研究指出,四款主流人工智慧模型在評估內容相同的口說回答時,通常給予美國和英國口音較高的分數,對中國和奈及利亞口音的評分則較低。這種差異影響了模型對說話方式和回答內容的判斷。
這項研究於 10 月 25 日在布達佩斯舉行的 EMNLP 2026 發表,測試了 Google 的 Gemini 2.5 Pro 和 Gemini 2.5 Flash、OpenAI 的 GPT Audio 1.5,以及阿里巴巴的 Qwen3 Omni。研究人員檢視求職面試、簡報和英語口說能力測驗等情境;在這些場合,評分可能影響一個人取得工作或教育機會的資格。
美國和英國口音通常排名最高,印度口音居中,中國和奈及利亞口音則排名最低。研究人員以來自這五個國家的 52 名人類說話者重做面試實驗後發現,口音造成的差距比使用人工語音時更大。
最令人憂心的發現涉及回答內容。有些說話者即使讀出完全相同的文字,且模型被要求只評估內容,仍因回答實質內容而獲得較低分數。口音影響了原本應聚焦於想法的評估。
華盛頓大學保羅.G.艾倫電腦科學與工程學院博士生、共同第一作者之一 Orevaoghene Ahia,描述模型解釋中呈現的模式:
它們聽得懂說話者,但似乎根據口音,對不同說話者抱持一種隱性的高低階層觀念。
研究人員如何確保文字內容不變
研究團隊使用 ElevenLabs 生成的語音,以五種英語口音朗讀相同的講稿,並包含男女聲。維持文字內容不變,讓研究人員得以檢視聲音的變化是否會影響評估。
講稿涵蓋面試回答、課堂簡報、研討會簡報,以及英語能力測驗的回答。四款模型各自以 1 至 7 分,分別評定表達方式和內容,並簡短說明評分理由。
表達方式涉及一個人如何說話,包括發音和清晰度;內容則關乎回答本身,例如其中的想法及其切題程度。將兩者分開評分,有助研究人員檢視對聲音的判斷是否也影響了對訊息的判斷。
這五種口音來自英語使用人口眾多、且研究人員有所聯繫的地區。因此,研究比較的是特定口音,而非世界各地所有英語變體。
艾倫學院副教授、研究資深作者 Yulia Tsvetkov 說明團隊選擇主流通用模型的原因:
我們想檢驗這些最先進的模型,因為企業可能會在實際場景中部署它們。
真人語音呈現更大的差距
接著,研究人員測試了來自同樣五個國家的 52 人所錄製的面試回答。每位參與者朗讀四段預先撰寫的回答,也回答了幾個沒有講稿的問題。
有講稿的測試提供了另一種比較方式,讓說話者說出相同的措辭;沒有講稿的回答則將測試延伸到由參與者自行組織內容的說話情境,更接近實際面試。
真人錄音中的口音差異造成的評分落差,大於生成語音中的差異。因此,真人驗證是這項研究的重要部分:這種模式不只出現在大規模控制實驗使用的人工語音中。
研究結果說明了評分的排序和差異方向,但公開說明未提供各模型和口音的確切平均分數及數值差距。讀者因此可以看出哪些群體通常得分較低,但典型扣分幅度仍未明確。
準確轉錄為何重要
模型常以語音不清楚或難以理解為由,解釋中國和奈及利亞口音為何得分較低。然而,研究人員發現,這些系統其實很擅長將相關錄音準確轉成文字。
Ahia 描述模型的批評與轉錄表現之間的落差:
儘管它們一再聲稱中國和奈及利亞說話者『含糊不清』或『難以理解』,但模型其實很擅長轉錄帶有口音的語音。
轉錄是指把某人說出的話寫下來。如果系統能準確記錄回答,卻批評回答難以理解,其解釋就值得檢視。在這項研究中,研究人員認為,這種落差與模型似乎偏好某些口音有關。
內容評分讓問題更加嚴重。說話者可能被扣兩次分:先是表達方式,再來是回答品質,即使回答的措辭根本沒有改變。在面試中,同一個回答可能只因說話者的聲音不同,就顯得比較差。
偏好與美式英語有關
研究團隊也分析了聲學特徵,也就是語音中可測量的特性。研究人員計算各口音與美式英語之間的「聲學距離」,亦即其聲音模式與美式英語基準的差異程度。
在這項比較中,中國和奈及利亞口音與美式英語基準的距離最遠,英國和印度口音則較接近。聲學距離越大,分數通常越低,顯示評分模式與聲音差異有關。
研究人員提出了幾種可能的解釋:訓練資料可能將某些口音描述為難以理解、納入的特定說話者樣本太少,或是助長了人們對專業人士應有何種說話方式的既定印象。
這些解釋仍是研究團隊提出的可能性。不過,實際風險很明確:若模型使用不均衡的樣本訓練,即使指令要求公平評估回答,模型仍可能在評估中帶入偏好。
奈及利亞以英語為官方語言,印度學校也以英語授課。然而,在這項研究中,兩國說話者的評分仍低於美國和英國說話者。在一個國家長期使用英語,並不代表這些模型會給予同等的評價。
測試內容與攸關利益
這些實驗評估的是通用人工智慧模型,而非求職平台或英語測驗業者實際採用的評分產品。企業可以利用這些模型開發應用程式,但商業評量系統有各自的設計和流程。
對求職者而言,令人擔憂的是評分過程可能在評估回答內容的同時,也對回答的聲音特徵有所扣分。學生的口頭報告或考試也可能面臨類似問題。這項研究將焦點放在這些判斷如何形成,以及它們如何影響一個人取得機會的可能性。
英語測驗的規模也相當可觀。根據論文引用的數據,培生 PTE Academic 在 2023 年約有 120 萬人應考;這項測驗會使用 AI 為部分口說回答評分,並用於簽證和移民申請。
PTE Academic 並未納入研究測試。研究人員引用這項測驗,是為了說明自動口說評量的普及程度。論文作者表示,他們不知道有任何公開的 AI 英語測驗評分稽核,而商業系統的內部運作通常也不對外公開。
Google 和 OpenAI 透過捐助部分資助這項研究,儘管兩家公司的模型都列入測試。這項資助關係也是檢視這兩家公司系統的研究背景之一。
研究發表時程
這項研究以〈聽起來不同的代價:音訊語言模型中的口音偏見〉為題發表,DOI 為 10.18653/2026.emnlp-main.1612,並收錄於 2026 年自然語言處理實證方法會議論文集。
以下日期顯示,會議發表早於 11 月的公開消息:
- 2026 年 10 月 25 日:研究團隊在匈牙利布達佩斯的 EMNLP 發表研究。
- 2026 年 11 月 5 日:相關發現對外公布,內容提及五種口音、四款模型,以及以 52 名人類說話者進行的驗證。
兩階段測試是研究結果的關鍵。生成語音讓研究人員能在大量樣本中維持文字內容不變;接著,真人錄音也呈現相同的整體偏好,而且不同口音之間的差距更大。
研究人員希望開發者做出哪些改變
Tsvetkov 呼籲,訓練和評估資料應更能代表實際使用語音系統的人。研究團隊也敦促開發者公布不同族群和方言的測試結果,而非只依賴單一平均分數。
平均分數會將所有人的結果合併成一個數字。如果系統對大多數群體表現良好,對較小群體卻表現不佳,這個綜合數字可能會掩蓋小群體的實際經驗。
Tsvetkov 以一個假設情境說明這項疑慮:
我們不希望系統對一般人口的平均準確率達到 97%,對較小群體的準確率卻只有 20%。
研究人員計畫檢視更多真人口音,包括各國境內的區域差異。他們也打算研究醫療領域的音訊應用,包括自動化緊急應變;在這類情境中,系統如何處理來電者的語音,可能立即造成重大影響。
針對招聘和英語評量,研究團隊建議直接測試口音公平性。評估應檢視不同口音的人是否受到相近待遇、內容評分是否聚焦於內容,以及系統聲稱的理由是否符合其理解錄音的能力。
重點整理
- 四款 AI 模型通常給予美國和英國口音最高評分、印度口音居中,中國和奈及利亞口音則最低。
- 即使說話者說出完全相同的內容,有些回答的內容分數仍會改變。
- 以 52 名人類說話者進行測試時,口音造成的評分落差大於使用生成語音時的落差。
- 模型能準確轉錄有時被它們描述為不清楚的語音。
- 研究檢視的是通用模型,而非商業招聘或英語測驗產品。
- 研究人員呼籲公布不同口音的評估結果,並計畫進一步研究區域口音和醫療音訊。