學習 RNA 字母及其連結的模型
中國科學技術大學的研究人員發布了 structRFM,這是一款開放的 RNA 基礎模型,以 2,100 萬組 RNA 序列與經計算標註的結構配對資料訓練而成。此次發布包含配對訓練資料、模型權重與原始碼,讓其他實驗室能取得材料重現研究並調整系統。
目錄
這項研究於 2026 年 11 月 4 日由《自然》發表,介紹一款能同時學習 RNA 分子構成單元的排列順序,以及協助分子折疊的連結關係的模型。研究團隊將模型調整為預測三維結構,稱為 Zfold;作者表示,Zfold 在 CASP15-natural、CASP16 與 RNA-Puzzles 評測中的表現,可與 AlphaFold3 相比。
structRFM 的實用之處,在於訓練完成後只需輸入 RNA 序列。模型產出的資訊可供研究人員執行多種任務,包括預測分子結構、辨識參與 RNA 加工的位點,以及依功能分類 RNA 分子。
《自然》的structRFM 研究論文將這項研究定位為一種方法,讓結構知識可應用於不同的預測任務。彭雄與 S. Kevin Zhou 為通訊作者,朱荷琴為第一作者。
為何折疊與序列同樣重要
RNA 參與蛋白質生成、基因調控,以及遺傳訊息的處理。RNA 序列是核苷酸的排列順序;核苷酸是分子單位,通常以 A、U、C 和 G 表示。排列順序承載資訊,而分子的折疊方式則有助於決定其功能。
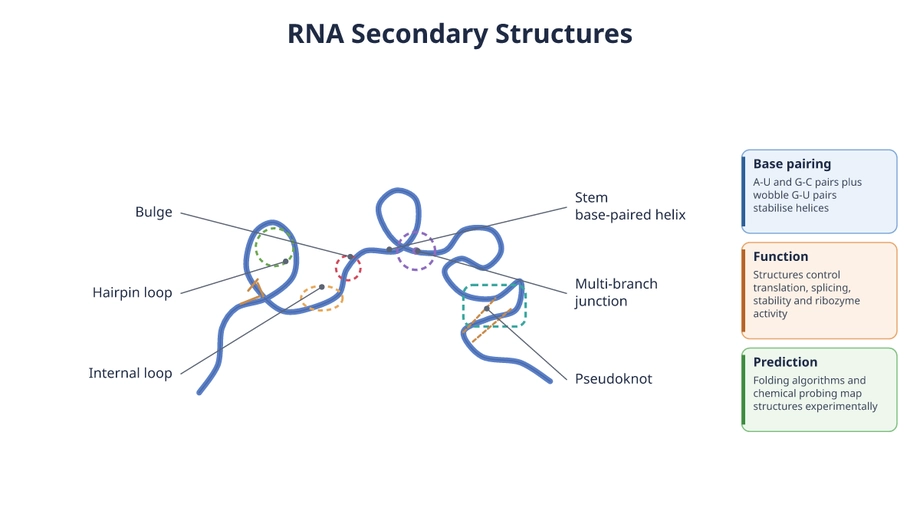
RNA 鏈的部分區段可以與同一條鏈上的其他區段配對。這些連結會形成二級結構,也就是由配對區域、莖部與環組成的模式。接著,分子會折疊成稱為三級結構的三維形狀,進而影響其活性及與其他分子的互動。
許多 RNA 語言模型從大型序列資料集學習模式,類似語言模型學習詞語之間的關聯。structRFM 在訓練時加入核苷酸配對資訊,協助模型學習序列上相距甚遠位置之間的連結。
研究團隊希望保留基礎模型的彈性:這類系統經過廣泛訓練後,可將學得的特徵調整至不同用途。團隊的目標,是將折疊資訊納入可共用的基礎模型,而非訓練一個只適用於單一結構任務的系統。
如何建立 2,100 萬組訓練配對資料
研究團隊建立了一個約含 2,100 萬組 RNA 序列與二級結構配對的資料集。結構標註由計算方法產生,讓研究人員能以遠大於僅由實驗解析結構所組成資料集的規模進行訓練。
電腦預測可能出錯,也可能反映產生預測的方法本身的優缺點。為降低對單一預測器的依賴,研究人員提出 MUSES,一種多來源二級結構集成方法。集成方法會整合多個預測來源的資訊,而非完全依賴單一來源。
MUSES 處理了以預測結構訓練模型時的一項核心問題:訓練標註中反覆出現的錯誤可能左右模型的學習結果。整合多種結構預測,旨在保留有用鹼基配對資訊的同時,降低預測器偏差。
研究的訓練與評估資源取自 RNAcentral、Rfam 與蛋白質資料庫等既有生物資料集。資料聲明列出相關版本,包括 RNAcentral 24.0 版,以及 Rfam 14.10 版和 15.0 版,方便研究人員追溯實驗所用資料集。
以隱藏資訊訓練模型
structRFM 使用遮罩語言模型訓練法:隱藏輸入中的部分內容,讓模型根據周遭脈絡還原缺失資訊。應用於 RNA 時,模型學習的是核苷酸之間的關係,而非詞語關係。
研究團隊透過配對匹配運算,將鹼基配對納入這個流程。動態遮罩比例在由結構連結引導的訓練與個別核苷酸位置遮罩之間取得平衡,讓模型有機會同時學習局部序列模式及與折疊相關的關係。
模型會產生三種特徵:整條序列的資訊、每個核苷酸的資訊,以及核苷酸配對的資訊。特徵是可供其他預測系統使用的數值表示法。不同任務可以採用這種表示法中的不同層次。
研究人員也進行了消融實驗,藉由移除或改動模型部分內容,檢驗各部分的作用。實驗結果支持結構資訊與遮罩策略都對研究所報告的效能提升有所貢獻,為 structRFM 的設計選擇提供佐證。
結構測試的結果
structRFM 在零樣本同源性分類中表現出色。同源性是指源自共同演化起源的關係。在此情境下,零樣本分類用來檢驗模型學得的表示法,能否在未針對目標分類任務進行訓練的情況下,有效辨識這類關係。
作者也指出,模型改善了二級結構預測,並在新發布的 RNA 家族資料上表現良好。RNA 家族是指具有共同序列或結構特徵的相關分子群。以新發布的家族進行測試,可檢驗模型在既有資料集所涵蓋的熟悉群組之外,是否同樣有效。
在三級結構預測方面,研究團隊將 structRFM 學得的特徵調整至可預測三維形狀的模型,開發出 Zfold。作者表示,預測出的形狀以及從這些預測結果推得的二級結構,都有所改善。
Zfold 在 CASP15-natural、CASP16 與 RNA-Puzzles 上接受評估;這些基準資料集用於評量分子結構預測。論文指出,Zfold 在這些評估中的表現可與 AlphaFold3 相比。這項比較針對 Zfold 在上述基準上的結果,而底層 RNA 表示法則由 structRFM 提供。
研究呈現的是多種面向的成果,而非一個可涵蓋所有用途的準確率分數。辨識相關序列、預測鹼基配對,以及重建三維形狀是不同問題,各自需要不同的評估方式。
從 RNA 加工到功能分類
研究也以功能相關任務測試 structRFM,包括剪接位點預測、內部核糖體進入位點辨識,以及非編碼 RNA 分類,將評估範圍延伸至分子形狀以外。
剪接位點標示細胞處理 RNA 訊息時使用的邊界。在剪接過程中,部分區段會被移除,剩餘區段則會接合。預測這些邊界有助於研究人員檢視遺傳訊息在用於製造蛋白質之前如何組裝。
內部核糖體進入位點(IRES)是 RNA 區域,可讓負責製造蛋白質的細胞機制從內部啟動轉譯。辨識 IRES 需要從序列中找出功能模式,因此這項任務也能檢驗預訓練過程所擷取的資訊。
非編碼 RNA 的功能並非作為製造蛋白質的模板。對其進行分類,就是將分子歸入相關群組。作者表示,模型在這些功能任務上的表現均有所提升,顯示當預測目標從結構轉為生物功能時,學得的表示法仍然有用。
研究團隊也透過分段策略,將模型延伸至長鏈非編碼 RNA 分類。將長序列切分成多個區段,便能將模型用於原本難以整段處理的輸入內容。
開放發布為研究人員提供什麼
此次發布涵蓋三種用途各異的資源。資料集提供模型學習所用的範例;模型權重包含訓練期間學得的數值;原始碼則說明軟體的實作與執行方式。
取得模型權重後,研究人員可以使用已訓練完成的模型,無須重做整個預訓練流程。取得資料與程式碼,則有助於深入檢視訓練程序、重現實驗,以及開發替代方法。
論文列出專案在 GitHub 上的程式碼庫 heqin-zhu/structRFM,也列出預訓練資料集的 Zenodo 封存檔,DOI 為 10.5281/zenodo.18272040;原始碼與模型檢查點的封存檔 DOI 則為 10.5281/zenodo.18274292。DOI 是一種永久識別碼,旨在讓研究資源能長期追溯。
資料聲明指出,訓練與測試資料集可透過專案程式碼庫公開取得。聲明也提供研究所用的 IRES 處理後資料分組,以及圖表的基礎資料。作者表示,資料取得不受任何限制。
這些細節對研究結果的比較很重要。研究人員可以檢視所用資料集與資料分組、重新執行評估,並測試不同訓練選擇是否會改變結果。因此,此次發布不僅便於重用模型,也有助於檢視研究發現。
研究團隊與發表時程
這項研究由中國科學技術大學生物醫學工程學院,以及醫學影像、機器人、分析計算與學習實驗室(MIRACLE)主導。作者列出的機構包括位於合肥的單位,以及中國科學技術大學蘇州高等研究院。共同作者李瑞峰則隸屬杭州的浙江大學計算機科學與技術學院。
教授 Zhou 與特任研究員 Xiong 共同構思並監督研究。Zhu 負責設計與實作架構、進行預訓練及多項結構預測與 RNA 分類實驗,並分析結果。其他團隊成員則負責同源性測試、資料集比較、IRES 辨識與結構評估。
研究成果的發表與公開介紹分別落在兩個日期:
- 2026 年 11 月 4 日:《自然》刊出〈An open structure-guided RNA foundation model for generalizable prediction〉。
- 2026 年 11 月 5 日:研究成果與開放發布在中國公開介紹,線上發表則被描述為於清晨刊出。
作者表示,研究經費來自中國國家自然科學基金、國家重點研發計畫、江蘇省與蘇州市的研究計畫,以及深圳市三名工程。作者聲明沒有利益衝突。
研究成果如何改變 RNA 研究
structRFM 為多種研究活動提供共同起點。研究 RNA 加工的實驗室,可以調整另一個團隊用於研究折疊或分類非編碼分子的同一套基礎模型。每種應用仍需要針對自身任務進一步開發與評估。
2,100 萬組訓練配對、結構引導式學習,以及公開發布的模型檢查點,讓研究人員能直接檢視一套具體系統,而不只是閱讀演算法描述。MUSES 與遮罩實驗也提供了明確的設計選擇,供其他團隊測試或調整。
研究報告的成果聚焦於計算預測與分類。若要推進至生物醫學應用,仍需進行更多生物實驗,包括檢驗預測結構,以及測試對特定 RNA 分子指派的功能。
論文沒有提供臨床應用的時程。眼前的改變在於取得資源:全球研究人員都能取得訓練資源、檢視實作方式,並探究論文報告的效能提升是否適用於自己的 RNA 資料集。
重點整理
- 中國科學技術大學研究人員發布 structRFM,這款 RNA 基礎模型以約 2,100 萬組序列與二級結構配對資料訓練而成。
- 模型學習序列模式與鹼基配對關係,之後僅需輸入序列即可產生特徵。
- MUSES 整合多個結構預測來源;動態遮罩則在訓練時平衡結構資訊與核苷酸資訊。
- 作者指出,模型在同源性分類方面表現良好,並改善了二級結構預測,包括在新發布 RNA 家族資料上的測試。
- 用於三級結構預測的調整版本 Zfold,在三個指定基準資料集上的表現被形容為可與 AlphaFold3 相比。
- 資料集、模型權重、原始碼與評估資源均已公開,可供重用與重現研究。