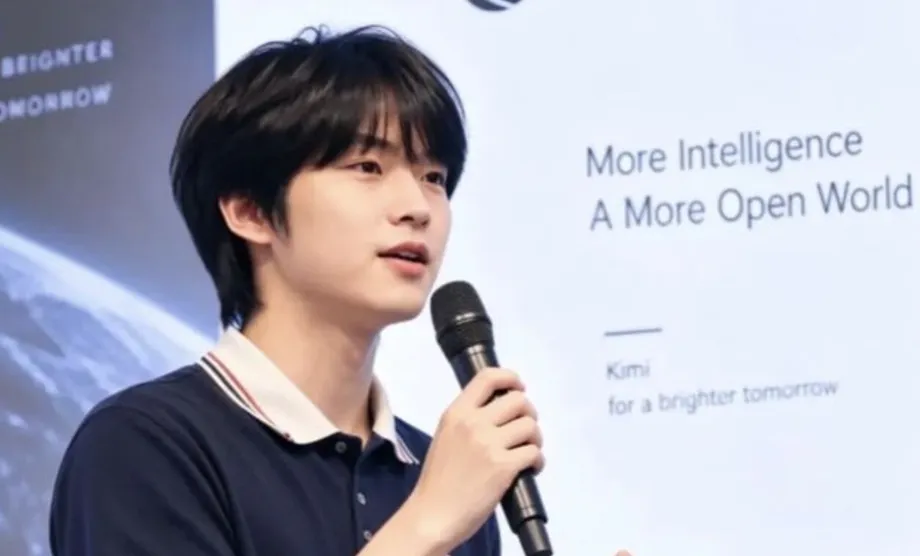
協助重新設計 Kimi 後,少年研究員離職
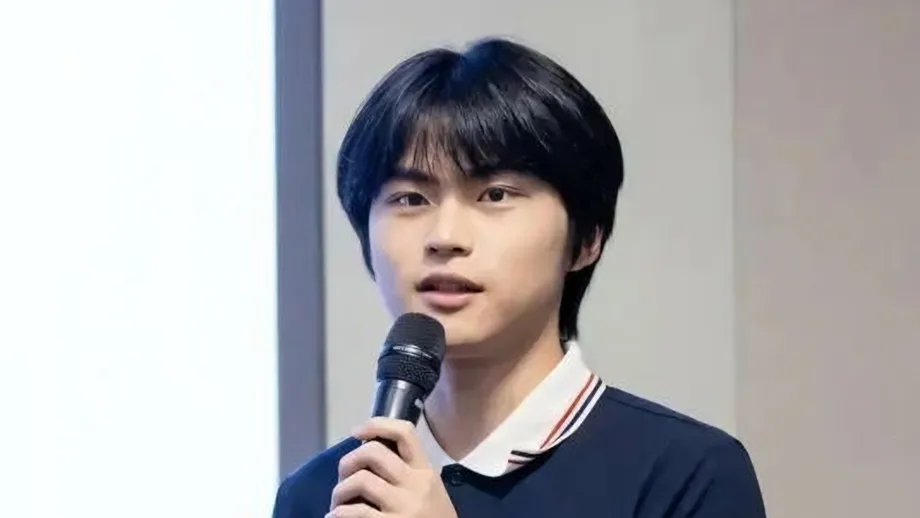
17 歲研究員陳光宇協助開發一種讓人工智慧模型在不同層之間傳遞資訊的新方法。他於 2026 年 10 月 15 日宣布離開中國公司月之暗面(Moonshot AI),該公司旗下產品為 Kimi。他在 16 歲時於 2025 年 11 月加入研究團隊。
目錄
陳光宇在國際上以 Nathan Chen 之名為人所知。離開公司時,他已完成一項具體研究貢獻:與月之暗面研究員張宇(Yu Zhang)及蘇劍林(Jianlin Su)共同列為第一作者,發表論文《注意力殘差》(Attention Residuals),刊於 2026 年 3 月 16 日。根據 Kimi 7 月發布時的相關說明,這項技術後來成為 Kimi K3 的一部分。
相較於外界對他年齡的關注,月之暗面公布的實驗更精確呈現這項研究的成果。在一個擁有 480 億參數的 Kimi Linear 模型測試中,研究人員記錄到所有受評估任務的成績均有所提升。他們的區塊注意力殘差(Block Attention Residuals)方法,表現也達到一個使用多 1.25 倍運算資源的傳統模型之訓練損失水準。
陳光宇離職後,Anthropic 公開邀請他加入;外界也猜測他可能前往一家由前 Google 研究員創立的新創公司,並試圖將他與一名據稱手握五份工作邀約、每份年薪約 100 萬美元或更高的匿名少年聯想在一起。
不過,陳光宇已公開否認將加入 Anthropic。他的下一個雇主、薪酬方案,以及是否重返大學,目前都尚未獲得確認。
在告別訊息中,陳光宇談到自己在月之暗面的經歷,並感謝錄用他的人。這名即將離職的機器學習研究實習生寫道:
過去這一年是我人生中最美好的一年。
他的訊息以繼續探索的心願作結,並未透露明確去向。
陳光宇對研究的貢獻
陳光宇與張宇、蘇劍林的名字並列於 Kimi 團隊的《注意力殘差》報告,並註明三人貢獻相同。這項註記表示,三人皆對一項規模更大的團隊研究作出主要貢獻。
以旋轉位置嵌入(RoPE)研究聞名的蘇劍林進行了初步實驗。RoPE 能協助語言模型掌握文字或其他資訊在序列中的位置。張宇則是 Kimi Linear 架構研究的第一作者。
蘇劍林曾表示,張宇與陳光宇協助將早期的注意力殘差構想,轉化為適用於大型模型的實際方法。兩人共同提出區塊注意力殘差(Block AttnRes),在保留效益的同時,降低大規模應用這項方法所需的記憶體與通訊成本。
陳光宇也參與加速 Kimi Delta Attention(KDA)運算核心的工作。運算核心(kernel)是一種在圖形處理器上執行特定計算的小型程式。改善運算核心可讓相同硬體更快完成任務。
因此,他的工作橫跨兩個相互關聯的領域:決定模型應如何建構,以及讓支撐這項設計的計算高效率地執行。對訓練大型模型的研究機構而言,這兩方面都會影響其運算預算能支撐多少研究工作。
注意力殘差如何改變模型
語言模型會透過多個連續層處理資訊。每一層都會轉換收到的資訊,逐步建構出後續層用來預測答案的表徵。
標準殘差連接會將各層的輸出相加,讓較早的資訊持續傳遞。月之暗面的官方研究程式碼庫指出,這種做法有一項問題:模型愈深,反覆累積就愈可能稀釋個別貢獻,並使內部訊號的幅度增大。
注意力殘差以可學習的選擇機制,取代固定的資訊累積方式。後續層可以依據目前的輸入,為較早產生的資訊分配不同權重。這就像讀者參考前幾章中最有用的筆記,而非讓每一份筆記都同等重要地一路帶到最後。
若要針對每個更早的層分別進行選擇,也會帶來額外成本。區塊注意力殘差將各層分組,在組內保留一般的加法運算,再從各組的表徵中進行選擇。程式碼庫指出,約八個分組就能取得完整方法的大部分效益。
論文所述規模最大的 Kimi Linear 設定使用 54 層,每六層分成一組。九個分組加上初始詞元表徵,總共提供 10 個資訊來源供模型選擇。這項實務工程改良,協助這個構想從實驗走向大型模型訓練。
已發表研究結果
3 月的論文在一個總參數量為 480 億的 Kimi Linear 模型上測試注意力殘差,其中處理時啟用的參數為 30 億。參數是模型內部經學習調整的數值設定。只啟用部分參數,能讓模型運用大量已學得的知識,同時限制每一步所需的計算量。
訓練使用了 1.4 兆個詞元,也就是模型處理的文字或其他資料片段。研究人員維持模型其他主要架構元件不變,因此能將加入注意力殘差後的結果與基準設計進行比較。
在測驗高難度科學問題的 GPQA-Diamond 測試中,分數從 36.9 提升至 44.4,增加 7.5 分。測試程式碼生成能力的 HumanEval,分數從 59.1 提升至 62.2。綜合知識基準測試 MMLU 則從 73.5 升至 74.6。
運算資源的比較也值得參考。若能追上使用 1.25 倍運算資源的基準模型,就代表只用該基準模型五分之四的預算,也能達到相同的已報告訓練損失,亦即減少 20% 運算資源。訓練損失衡量模型在訓練期間的預測與目標答案相差多遠。
月之暗面另稱,這項技術讓 K3 的訓練效率提升約 25%,額外開銷不到 2%。3 月的實驗與後來關於 K3 的說法,涉及不同的模型設定;上述詳細基準測試數據來自 Kimi Linear。
從校園黑客松到研究團隊
陳光宇 2009 年出生於深圳。加入月之暗面之前,他曾組織青少年開源社群、開發軟體機器人,並探索從 AI 安全到物理等不同領域。
準備大學申請期間,他暫停了一些自己不感興趣的活動,開始閱讀真正感興趣的主題。此後,他透過自主學習、公開撰寫技術文章,以及與業界研究人員交流,逐步進入研究領域。
2025 年 2 月,他帶著「第三隻手」(ThirdArm)專案參加月之暗面為中學生舉辦的 AI 黑客松。這項專案設想增加一隻機器人輔助臂。他在活動中認識奇績創壇(MiraclePlus)創始團隊成員董可涵,對方鼓勵他投入前沿科技。
之後,陳光宇發表一篇關於 DeltaNet 的技術文章,獲研究員楊松林回覆。這段討論又讓他與加州帕洛阿圖新創公司 Tilde Research 的 Ben Keigwin 聯繫上,並開始交流公司的研究工作。2025 年 7 月,年僅 16 歲的陳光宇獨自前往當地,進行為期七週的實習。
陳光宇的學習方式包括花數小時與 Gemini 討論論文,傳送難懂段落的截圖並提出後續問題。他也閱讀程式碼、部落格文章和研究人員的網站,並向 DeepSeek 研究員袁景陽請教重要選擇。
他的經歷不只是把聊天機器人當家教。透過公開寫作,他讓外界看見自己的技術思考;研究人員對此作出回應,實習機會則讓他能將想法轉化為協作成果。
快速崛起的時間軸
不到兩年內,陳光宇從校園專案走向國際實習,再投入已發表的模型研究。他離職時,注意力殘差已應用於 Kimi 的重要版本。
- 2025 年 2 月:陳光宇參加月之暗面為中學生舉辦的 AI 黑客松。
- 2025 年 7 月:他開始在帕洛阿圖的 Tilde Research 實習,為期七週。
- 2025 年 11 月:16 歲的他以機器學習研究實習生身分加入月之暗面的 Kimi 團隊。
- 2026 年 3 月 16 日:《注意力殘差》技術報告發表,陳光宇、張宇與蘇劍林列為同等貢獻作者。
- 2026 年 6 月:陳光宇高中畢業。
- 2026 年 7 月:Kimi K3 發布,將注意力殘差列為架構技術之一。
- 2026 年 10 月 15 日:陳光宇宣布離開月之暗面。
- 2026 年 10 月 16 日:他否認將加入 Anthropic 的傳聞。
- 2026 年 10 月 20 日:匿名帳號聲稱他將加入 Discovery Loop。
他的公開教育經歷也列出 2026 年 8 月至 9 月就讀卡內基美隆大學。這段短暫的就學紀錄,成為外界猜測他下一步是就業或繼續升學的話題之一。
Anthropic 的邀請與百萬美元傳聞
Anthropic 可擴展強化學習團隊負責人 Sholto Douglas 在陳光宇的告別貼文下留言。他詢問陳光宇是否仍打算就讀卡內基美隆大學,並邀請他到舊金山一起工作。
陳光宇回覆說自己正前往舊金山灣區。這段對話引發他已加入 Anthropic 的猜測時,他簡短否認:
沒有 :)
薪酬討論則是另一回事。Menlo Ventures 投資人 Deedy Das 描述,他曾遇到一名未具名的 17 歲少年。這名少年在語言模型協助下自學 AI,曾在一家頂尖 AI 公司實習約一年,並在一所美國排名頂尖的大學就讀兩週後離校。
Das 表示,這名少年拿到舊金山頂尖 AI 實驗室的五份工作邀約,每份年薪約 100 萬美元或更高。Das 也轉述,該少年更重視學習而非金錢。
社群媒體使用者因為年齡與研究經歷相近,將這段描述與陳光宇連結在一起。Das 並未透露這名少年的身分,陳光宇也未證實那些邀約是發給自己的。因此,這場討論聚焦的是一名身分未公開者據稱收到的邀約,而非陳光宇已公開的聘僱協議。
Douglas 公開邀請陳光宇,是更具體的興趣訊號:一名資深研究員公開鼓勵他加入。陳光宇隨後的否認,也直接回應了他將加入 Anthropic 的猜測。
Discovery Loop 為何成為討論焦點
10 月 20 日,追蹤 AI 人才流動的匿名帳號 Arfur Grok 聲稱陳光宇已加入 Discovery Loop,此後該公司成為討論焦點。陳光宇尚未證實任職消息,而這家新創公司則以不評論人事事務為由拒絕回應。
Discovery Loop 於 2026 年 8 月由前 Google 研究員 Jeff Dean、Sanjay Ghemawat、Quoc Le 和 Oriol Vinyals 創立。該公司表示,目標是運用 AI 自動化科學與機器學習研究,包括提出構想、執行實驗及分析結果。
對於關注模型效率設計的研究員而言,這項使命涉及熟悉的技術難題。要執行大量研究實驗,系統必須有效運用運算資源;改善演算法或運算核心,就能在固定預算內進行更多實驗。
Discovery Loop 的融資也引發關注。據報導,該公司 9 月尋求以約 500 億美元估值募資;幾週前,相關討論估值約為 100 億美元,增幅達五倍。這些數字指的是募資洽談期間提出的公司估值。
陳光宇原本就與灣區有所連結,曾在 Tilde Research 實習。他先前的實習經歷,也說明他前往加州可能是為了接觸多位業界人士,而非前往單一明確目的地。
他的離開對月之暗面意味著什麼
曾支持在陳光宇 16 歲時聘用他的月之暗面研究員杜宇倫表示,兩人曾多次長談,討論他的離職決定。杜宇倫雖感到惋惜,但也支持陳光宇趁著年輕探索新興趣。
陳光宇的貢獻仍留在團隊的研究成果中。7 月發布、擁有 2.8 兆參數的 Kimi K3,結合了注意力殘差與 Kimi Delta Attention。兩者處理資訊的不同面向:AttnRes 改變資訊如何穿過模型的深度傳遞,KDA 則協助高效率處理序列。
月之暗面表示,與 K2 相比,K3 的擴展效率提升約 2.5 倍,這是架構變更、訓練方法與資料選擇共同帶來的成果。這也顯示,陳光宇的工作是公司更廣泛努力的一環,背後還有許多研究人員及多項技術改進。
實際影響不只關乎一名年輕員工的職涯。學習效率更高的模型,能更充分運用昂貴的處理器與研究預算。能將數學設計與快速實作結合的研究員,也能直接為此目標作出貢獻。
陳光宇離開月之暗面時,已累積發表研究成果、兩種研究環境的經驗,也受到另一家頂尖實驗室公開關注。已獲確認的經歷本身就很不平凡:一名少年協助將架構構想轉化為可用方法,之後選擇繼續探索,尚未宣布下一個職位。
重點摘要
- 又名 Nathan Chen 的陳光宇於 2026 年 10 月 15 日宣布離開月之暗面,當時 17 歲。
- 他與張宇、蘇劍林共同列為《注意力殘差》第一作者,論文於 3 月 16 日發表。
- 月之暗面實驗顯示,所有受評估任務的表現均有所提升,且達到使用 1.25 倍運算資源的基準模型水準。
- 陳光宇協助開發區塊注意力殘差,並參與加速 Kimi Delta Attention 的計算。
- 他表示正前往灣區,並否認將加入 Anthropic 的猜測。
- 他將加入 Discovery Loop 的說法,以及外界將他與五份每份約 100 萬美元的工作邀約連結,均尚未獲得證實。